
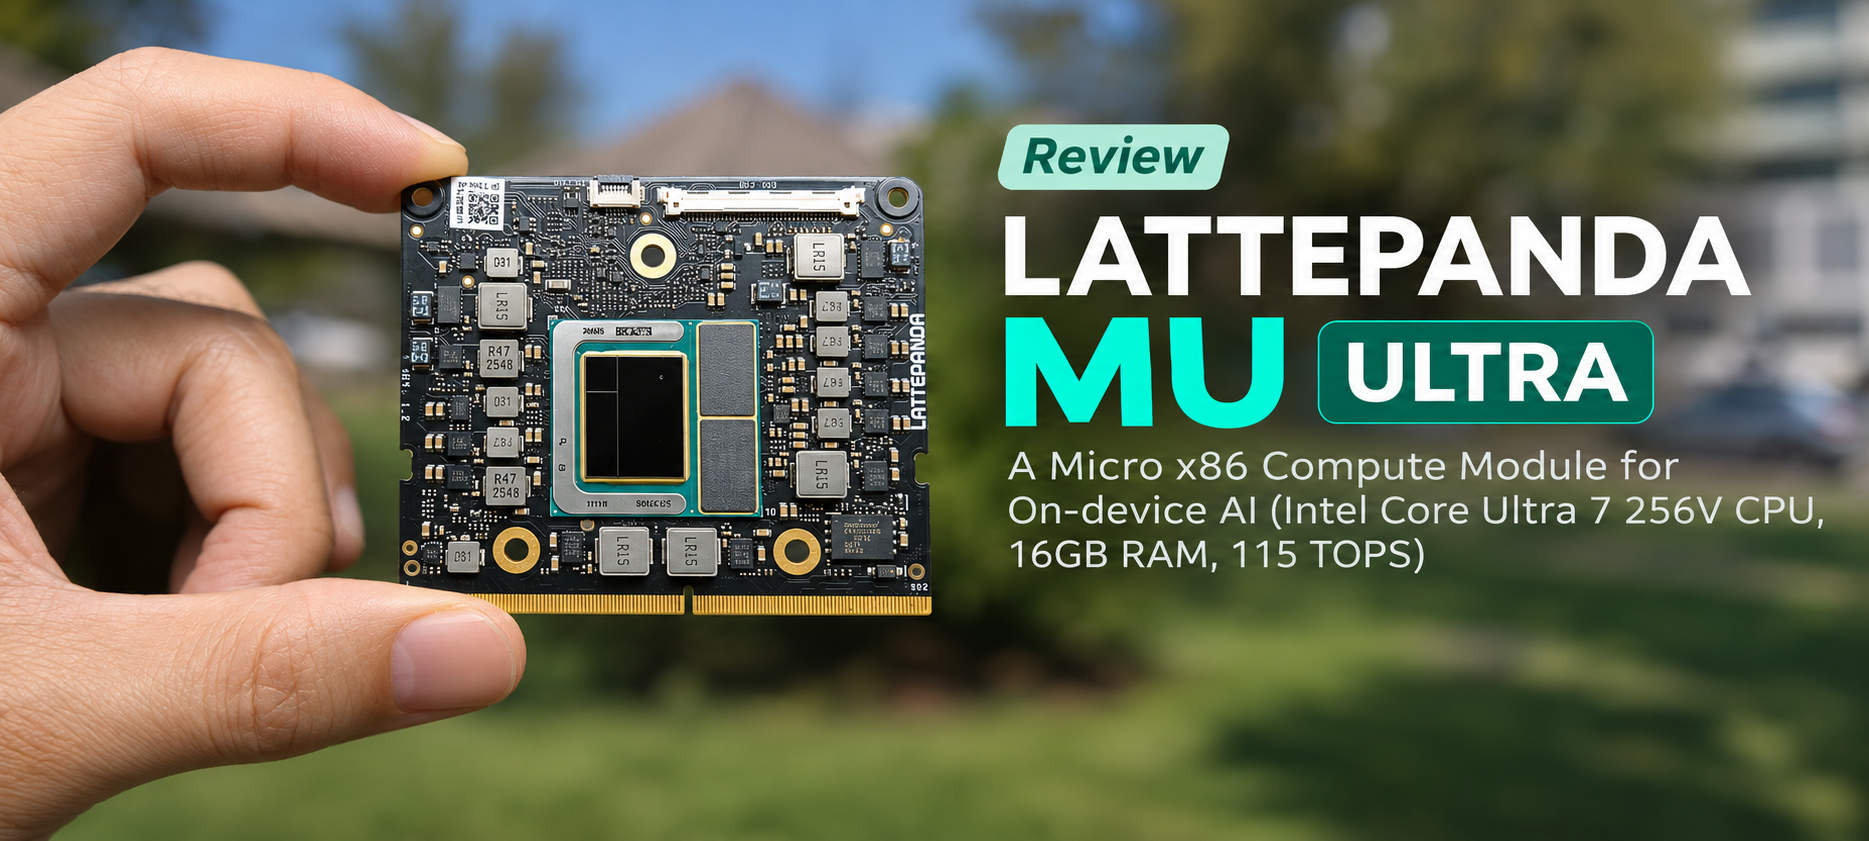
สวัสดีครับ วันนี้ผมจะพามารีวิว LattePanda Mu Ultra ซึ่งเป็นมอดูลคอมพิวเตอร์ x86 ขนาดกะทัดรัด ออกแบบมาสำหรับงาน AI บนอุปกรณ์ (on-device AI) โดยมีให้เลือก 2 รุ่น คือ Intel Core Ultra 5 226V และ Core Ultra 7 256V ทั้งสองรุ่นมาพร้อมหน่วยความจำ LPDDR5X ความเร็วสูง 16 GB ที่ 8533 MT/s และรุ่นท็อปให้พลังประมวลผล AI รวมสูงสุดถึง 115 TOPS
ในการรีวิวนี้ ผมติดตั้ง Ubuntu 26.04 แล้ววัดประสิทธิภาพของ LattePanda Mu Ultra ด้วยเครื่องมือหลายแบบ ทั้ง sbc-bench, Geekbench 7 และ Geekbench AI รวมทั้งมีการทดสอบประสิทธิภาพ CPU, GPU และ NPU ด้วย llama.cpp และ YOLO26 เพื่อดูว่าบอร์ดนี้รับงาน AI ได้แค่ไหน สุดท้ายผมสร้างเดโมสนุก ๆ ที่รวม YOLO26, MediaPipe และ OpenCV เข้าด้วยกัน เพื่อทดสอบการประมวลผลคอมพิวเตอร์วิชันแบบเรียลไทม์ รวมถึงการปรับภาพด้วยท่าทางมือผ่านเว็บแคม USB
แกะกล่อง LattePanda Mu Ultra
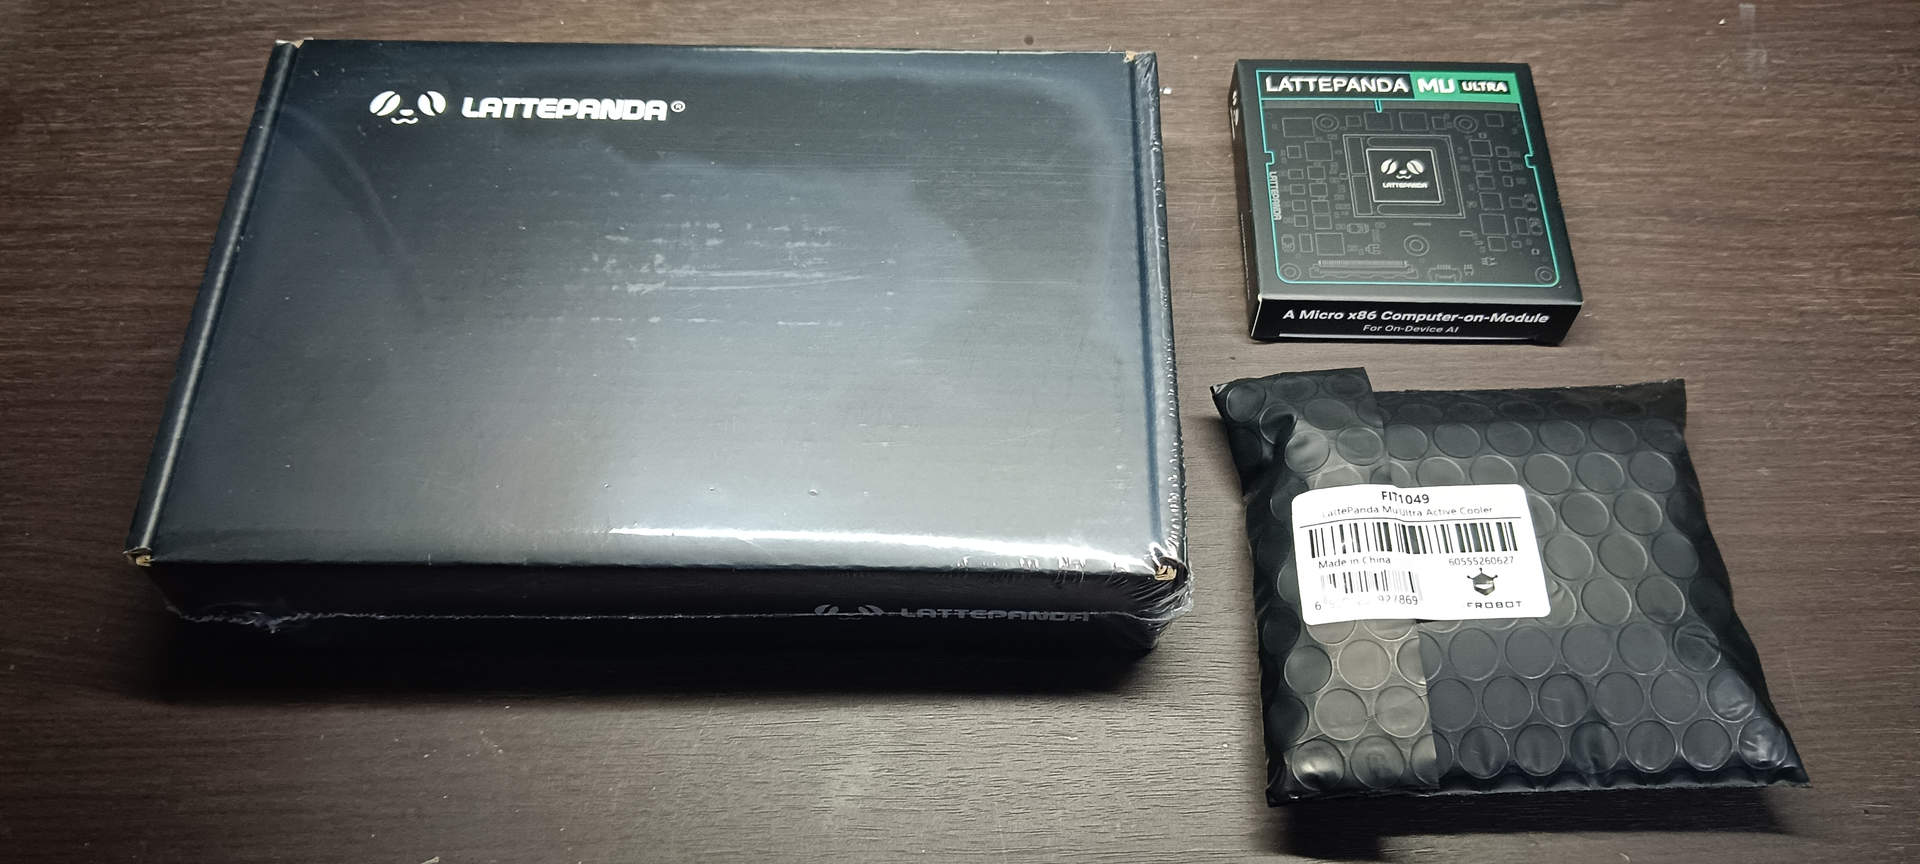
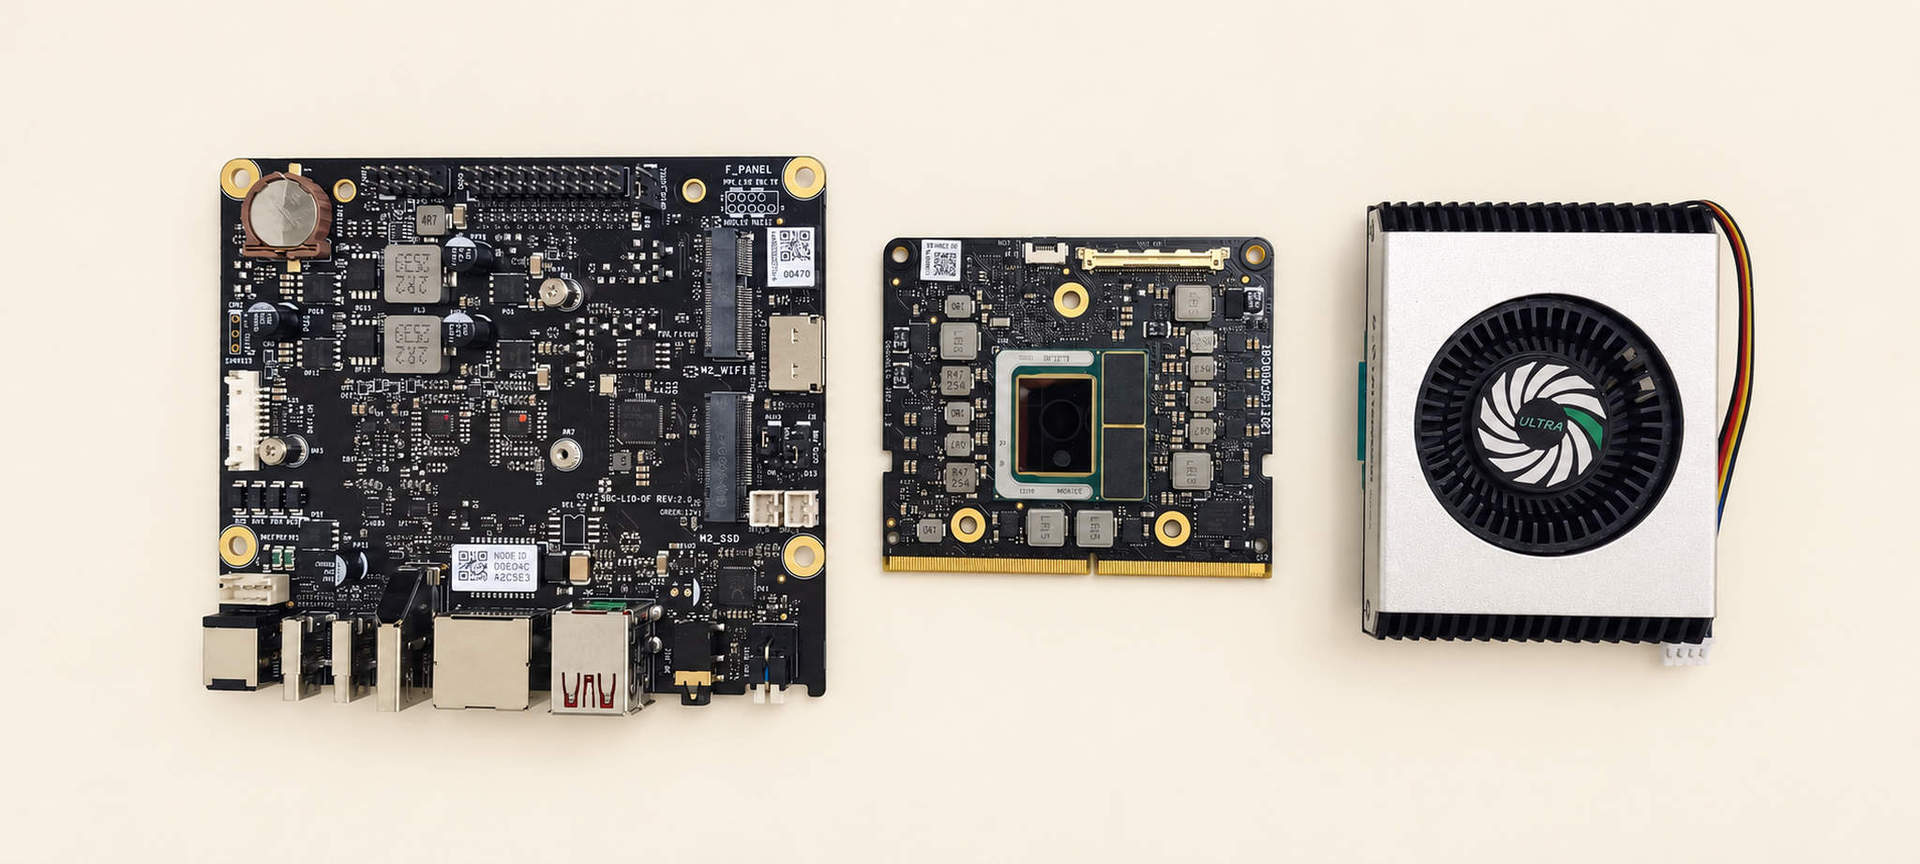
ผู้ผลิตส่งพัสดุมาจากจีนและมาถึงที่ทำงานผมภายในเวลาประมาณ 5 วัน ทุกอย่างบรรจุมาในกล่องกระดาษลูกฟูกมาตรฐาน มีโฟมกันกระแทกหนาแน่นเพื่อปกป้องชิ้นส่วนระหว่างการขนส่ง ในการรีวิวครั้งนี้ผมได้รับรุ่นที่ใช้โปรเซสเซอร์ Intel Core Ultra 7 256V ครับ นอกจากนี้ผู้ผลิตยังได้ส่ง Mini Carrier Board สำหรับ LattePanda Mu & Mu Ultra และ Aluminum Active Cooler สำหรับ LattePanda Mu Ultra มาให้ด้วย ทั้งหมดนี้ถูกบรรจุมาอย่างดีและอยู่ในสภาพสมบูรณ์ ไม่พบความเสียหายใด ๆ ดังภาพด้านล่างครับ
การประกอบชุดทดสอบ
การติดตั้งเบื้องต้น
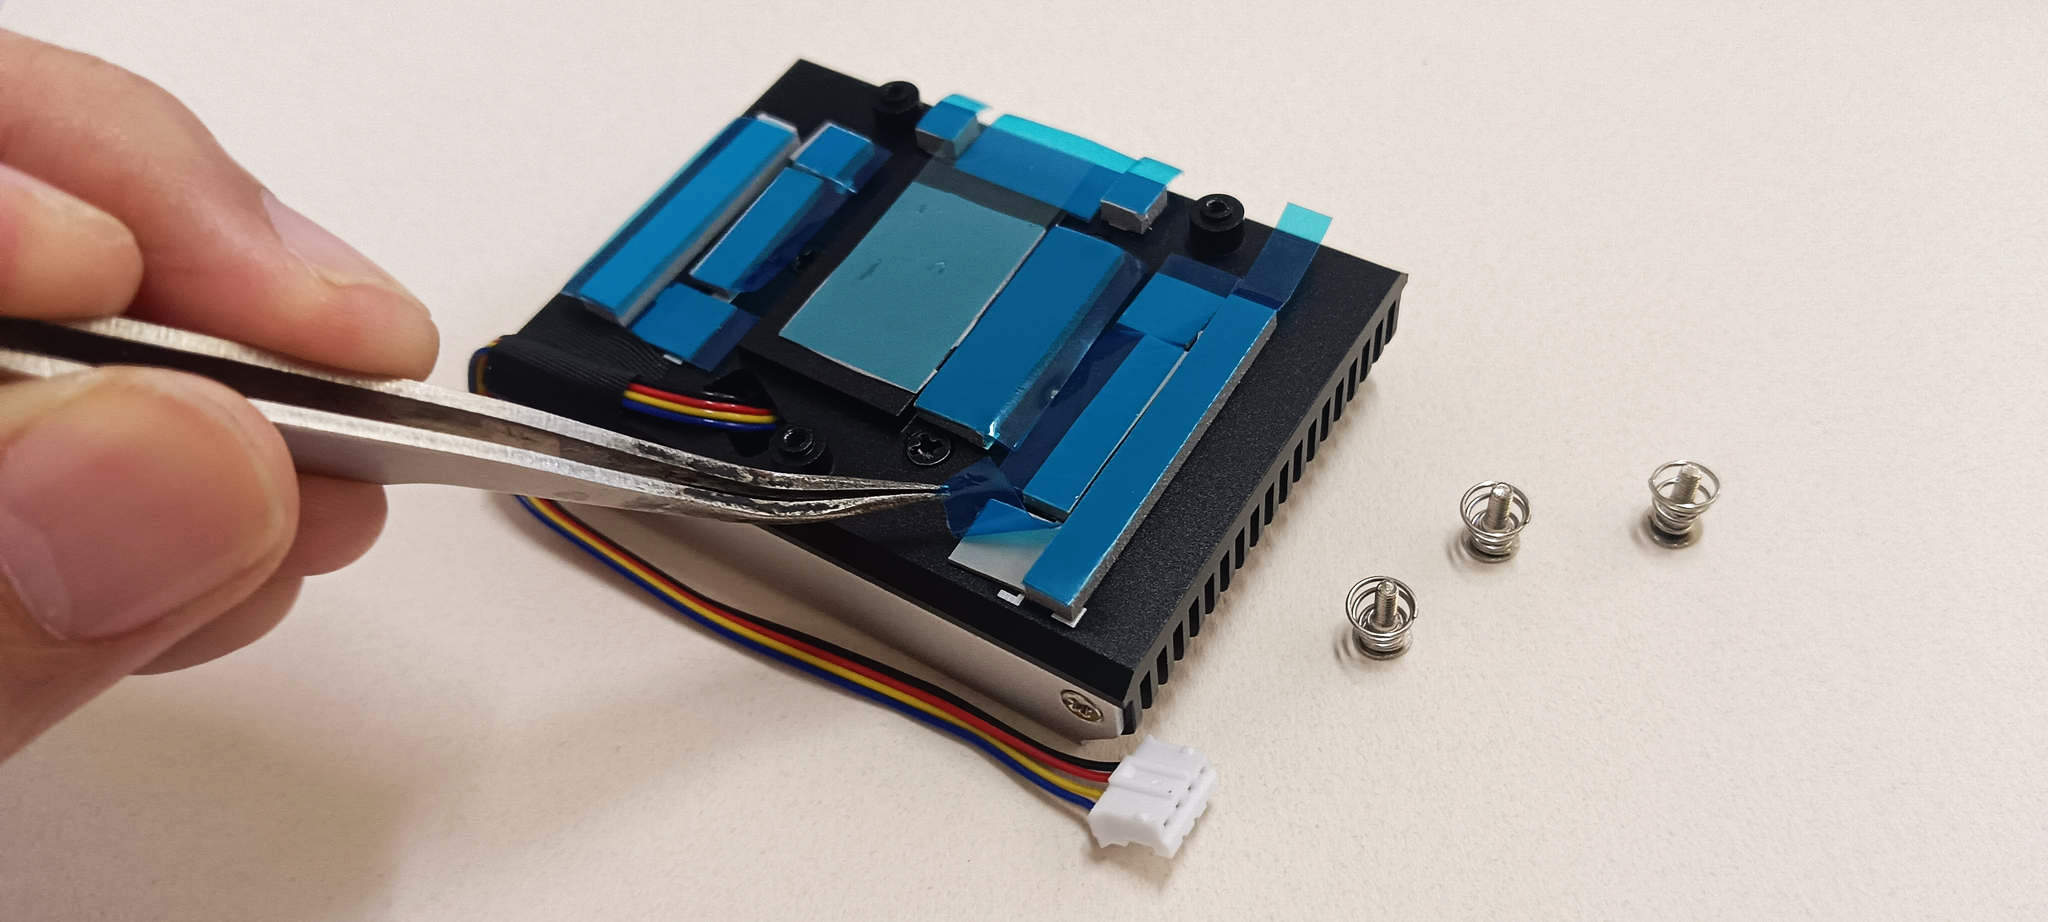
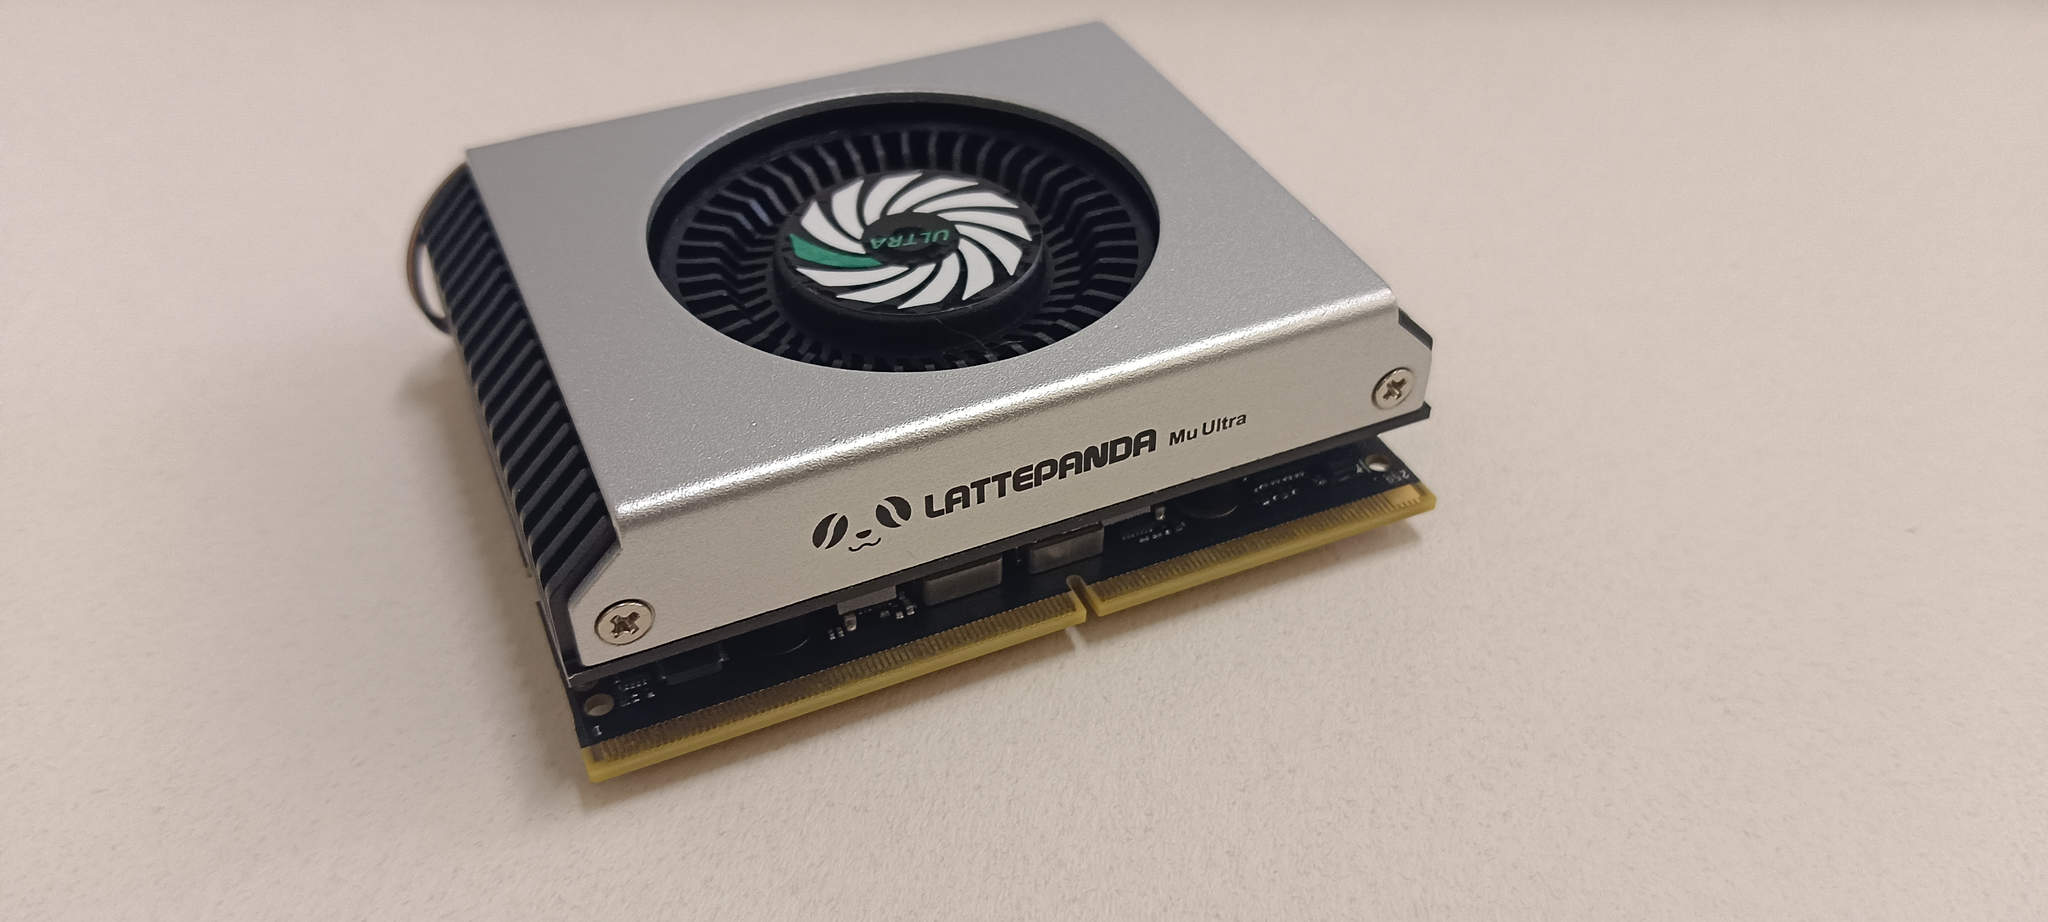
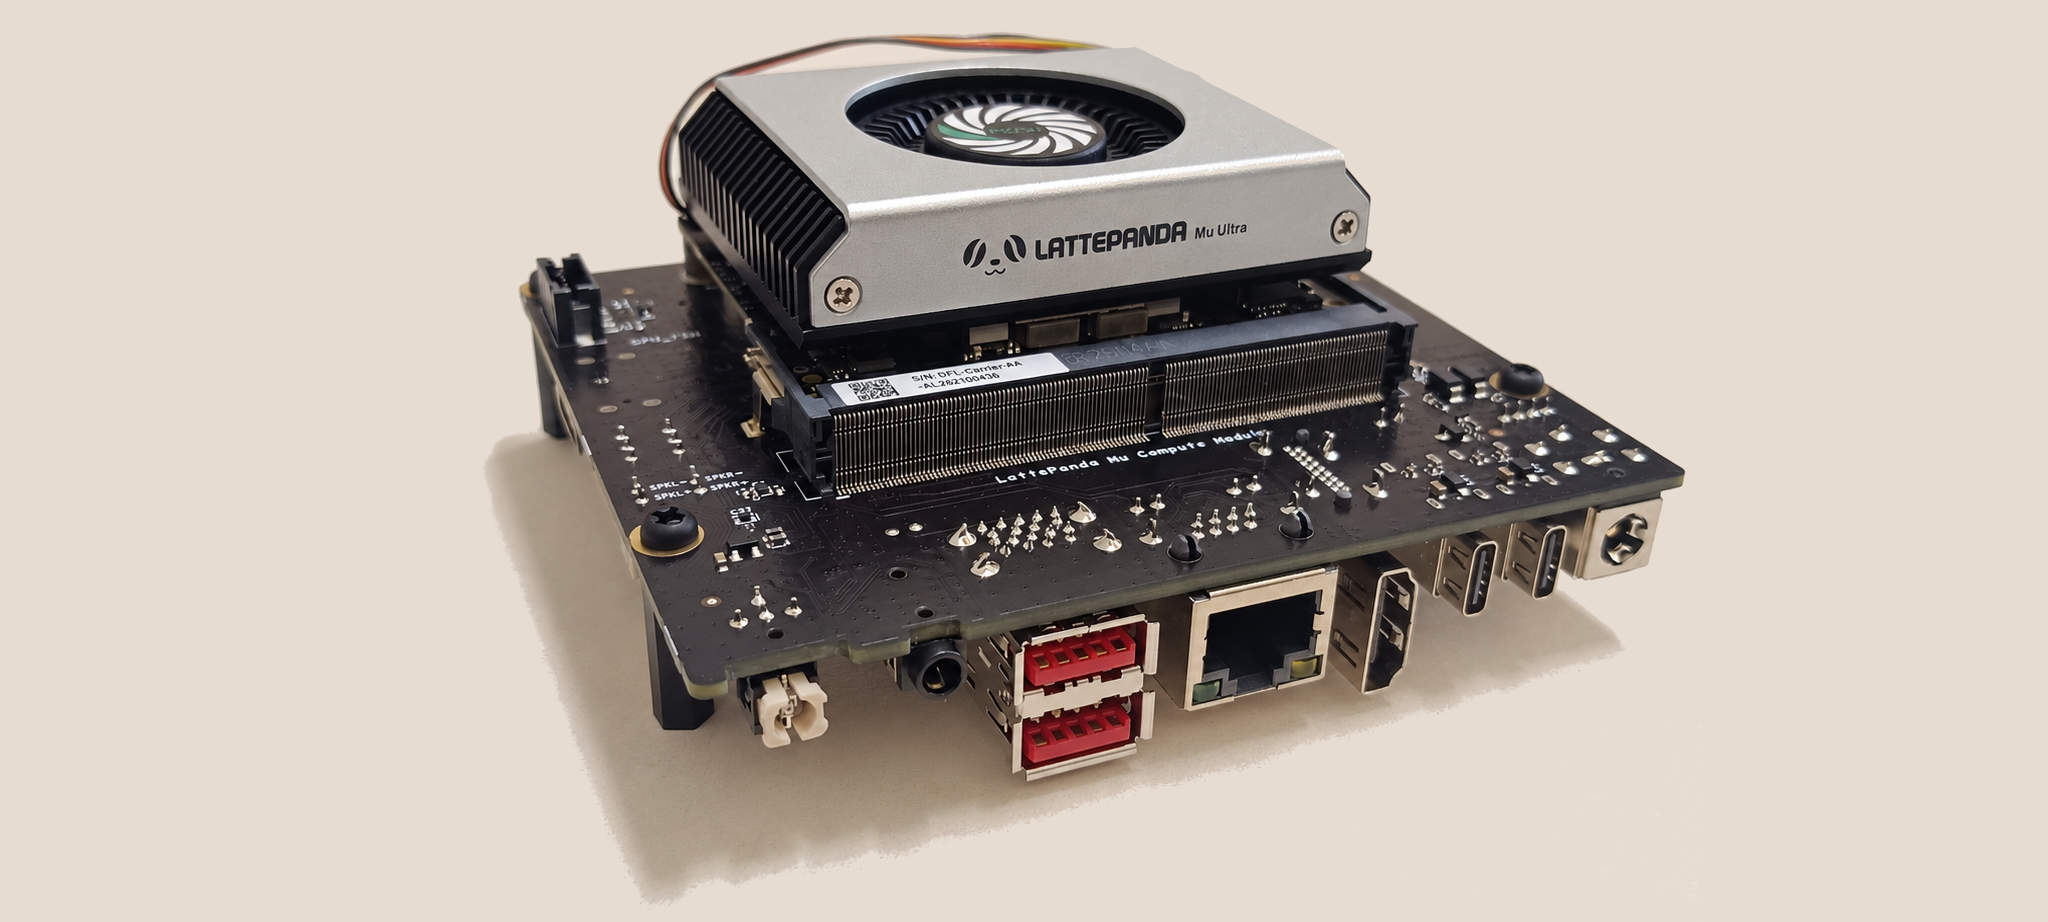
ผู้ผลิตมีคู่มือการติดตั้งและตั้งค่าโดยละเอียดอยู่ในหน้าคู่มือผลิตภัณฑ์อย่างเป็นทางการ ผมทำตามคำแนะนำทั้งหมดและขั้นตอนต่าง ๆ ก็ราบรื่นดี ไม่มีปัญหาใด ๆ โดยผมเริ่มจากติดฮีตซิงก์เข้ากับมอดูล LattePanda Mu Ultra เสร็จแล้วประกอบมอดูลลงบน carrier board จากนั้นติดตั้ง SSD M.2 NVMe สำหรับระบบปฏิบัติการและที่เก็บข้อมูล แต่เนื่องจากในชุดอุปกรณ์ที่ส่งมานั้นไม่มี SSD มาให้ ผมจึงนำ WD Blue SN5000 M.2 NVMe ความจุ 500 GB จากรีวิวฮาร์ดแวร์ครั้งก่อน ๆ ของผมกลับมาใช้
การติดตั้งระบบปฏิบัติการ (Ubuntu 26.04)
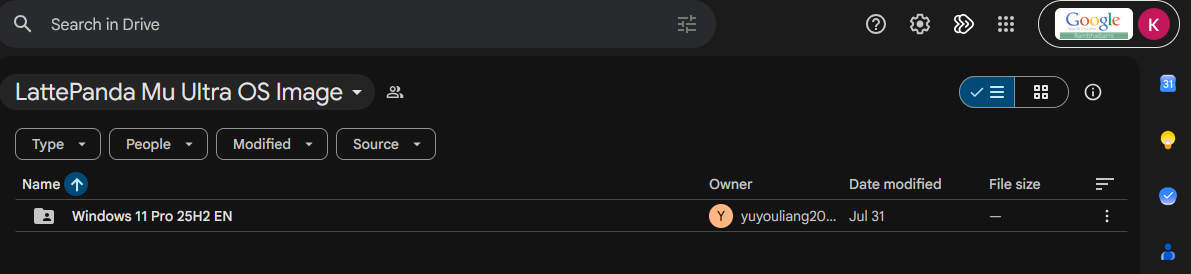
ผู้ผลิตมีอิมเมจรีคัฟเวอรี Windows 11 พร้อมไดรเวอร์ที่ติดตั้งไว้ให้แล้ว หรือจะติดตั้ง Windows ใหม่เองแล้วดาวน์โหลดไดรเวอร์แยกเองก็ได้
ในการรีวิวครั้งนี้ผมเลือกใช้ Linux ครับ และเนื่องจากคู่มือการติดตั้งของผู้ผลิตแนะนำ Ubuntu 24.04 LTS หรือใหม่กว่าขึ้นไป ดังนั้นผมจึงเลือก Ubuntu 26.04 LTS และใช้ Rufus เพื่อเตรียม USB สำหรับการติดตั้ง จากนั้นผมทำตามขั้นตอนมาตรฐานของ Ubuntu ซึ่งก็ผ่านไปได้โดยไม่มีปัญหาใด ๆ
จากนั้นผมตรวจเวอร์ชันเคอร์เนล Linux และความเข้ากันได้ของไดรเวอร์ก่อนที่จะดำเนินการต่าง ๆ ในขั้นตอนต่อไป โดยผมใช้คำสั่ง uname -r พบว่าระบบปฏิบัติการใช้เคอร์เนลเวอร์ชัน 7.0.0-38-generic ที่ผมทดลองแล้วสามารถใช้งานได้ตลอดการรีวิวนี้

การติดตั้งไดรเวอร์ Linux
ขั้นต่อไปคือติดตั้งไดรเวอร์ GPU และ NPU สำหรับไดรเวอร์ GPU นั้นผมได้ทำตามคู่มือติดตั้งไดรเวอร์ Intel GPU สำหรับคอมพิวเตอร์ และเลือกวิธีติดตั้งแพ็กเกจจาก Ubuntu PPA
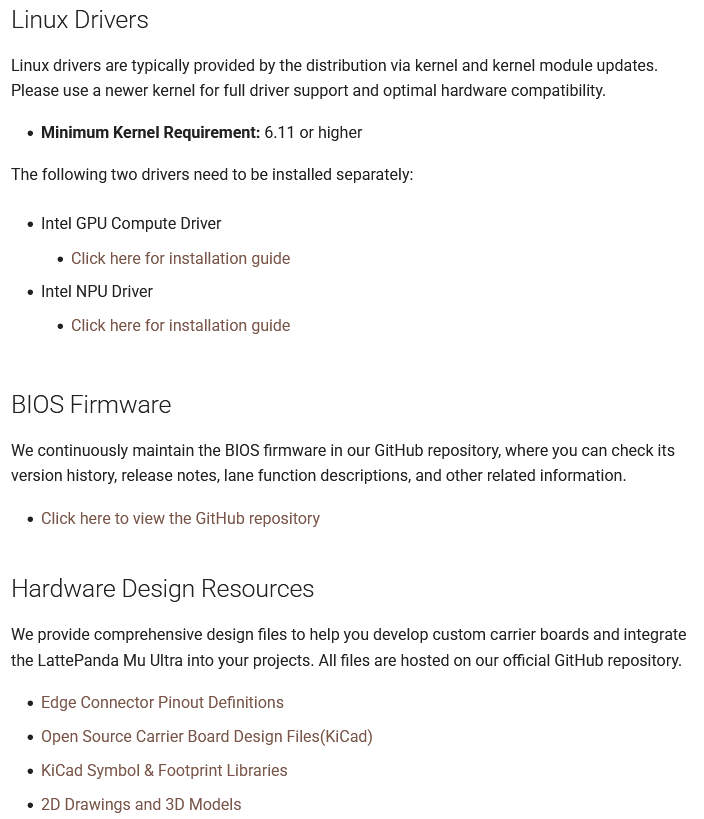
ส่วนไดรเวอร์ NPU นั้น ผมก็ทำตามคู่มือติดตั้งไดรเวอร์ Intel NPU โดยเริ่มจากตั้งค่า repository ของแพ็กเกจที่จำเป็นสำหรับ Ubuntu 26.04 แล้วติดตั้ง libtbb12 ซึ่งจำเป็นสำหรับ intel-driver-compiler-npu จากนั้นจึงติดตั้งแพ็กเกจไดรเวอร์ NPU ที่เหลือ รวมถึง libze1 สำหรับรองรับ Level Zero สุดท้ายผมจึงเพิ่มบัญชีผู้ใช้ของตัวเองเข้าไปในกลุ่ม render เพื่อให้เข้าถึงอุปกรณ์ GPU และ NPU ได้
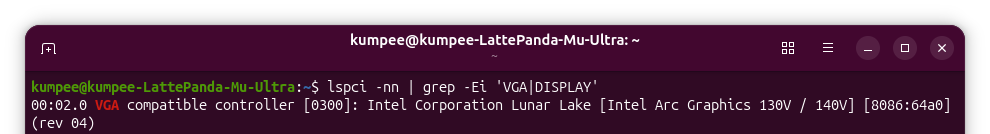
จากนั้นผมรันคำสั่งอีก 2 – 3 คำสั่งเพื่อตรวจว่า Linux มองเห็นและใช้งาน GPU แบบรวมได้ถูกต้องหรือไม่ ผลลัพธ์แสดงว่า Linux รู้จัก Intel Arc Graphics GPU (PCI ID 8086:64a0) และมี /dev/dri/card0 กับ /dev/dri/renderD128 ให้ใช้งาน ส่วน OpenCL ก็ตรวจพบ GPU เช่นกัน แปลว่าไดรเวอร์กราฟิกส์และไดรเวอร์ที่จำเป็นสามารถทำงานได้ตามปกติ ดังภาพด้านล่าง


ตรวจสอบข้อมูลฮาร์ดแวร์ด้วย inxi
ผมเริ่มต้นการรีวิว LattePanda Mu Ultra ด้วยคำสั่ง inxi -Fc0 เพื่อตรวจสอบดูการกำหนดค่าฮาร์ดแวร์และความเข้ากันได้กับ Linux
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 |
System: Host: kumpee-LattePanda-Mu-Ultra Kernel: 7.0.0-38-generic arch: x86_64 bits: 64 Desktop: GNOME v: 50.1 Distro: Ubuntu 26.04.1 LTS (Resolute Raccoon) Machine: Type: Embedded-pc Mobo: LattePanda model: LattePanda Mu Ultra v: Standard serial: DF-X256V-#A-AL262300171 Firmware: UEFI vendor: LattePanda v: SBCLNLCXR120-A date: 04/30/2026 CPU: Info: 8-core model: Intel Core Ultra 7 256V bits: 64 type: MCP cache: L2: 14 MiB Speed (MHz): avg: 400 min/max: 400/4700:4800:3700 cores: 1: 400 2: 400 3: 400 4: 400 5: 400 6: 400 7: 400 8: 400 Graphics: Device-1: Intel Lunar Lake [Intel Arc Graphics 130V / 140V] driver: xe v: kernel Display: unspecified server: X.Org v: 24.1.10 with: Xwayland v: 24.1.10 driver: dri: iris gpu: xe resolution: 1920x1080~60Hz API: EGL v: 1.5 drivers: iris,swrast platforms: gbm,x11,surfaceless,device API: OpenGL v: 4.6 compat-v: 4.5 vendor: intel mesa v: 26.0.8-1ubuntu0.3 renderer: Mesa Intel Graphics (LNL) Info: Tools: api: clinfo, eglinfo, glxinfo x11: xdriinfo, xdpyinfo, xprop, xrandr Audio: Device-1: Intel Lunar Lake-M HD Audio driver: snd_hda_intel API: ALSA v: k7.0.0-38-generic status: kernel-api Network: Device-1: Intel Ethernet I226-V driver: igc IF: enp2s0 state: up speed: 1000 Mbps duplex: full mac: 00:e0:4c:a2:c5:e3 Drives: Local Storage: total: 465.76 GiB used: 12.82 GiB (2.8%) ID-1: /dev/nvme0n1 vendor: Western Digital model: WD Blue SN5000 500GB size: 465.76 GiB Partition: ID-1: / size: 456.35 GiB used: 12.82 GiB (2.8%) fs: ext4 dev: /dev/nvme0n1p2 ID-2: /boot/efi size: 1.05 GiB used: 6.3 MiB (0.6%) fs: vfat dev: /dev/nvme0n1p1 Swap: ID-1: swap-1 type: file size: 4 GiB used: 0 KiB (0.0%) file: /swap.img Sensors: System Temperatures: cpu: 27.8 C mobo: N/A Fan Speeds (rpm): N/A Info: Memory: total: 16 GiB note: est. available: 14.8 GiB used: 4.56 GiB (30.8%) Processes: 383 Uptime: 10m Shell: Sudo inxi: 3.3.40 |
ผลด้านบนแสดงให้เห็นว่าบอร์ดรัน Ubuntu 26.04.1 LTS (Resolute Raccoon) พร้อมเคอร์เนล Linux 7.0.0-38 และ GNOME 50.1 โดยระบบตรวจพบหน่วยประมวลผลหลัก Intel Core Ultra 7 256V ได้อย่างถูกต้อง โดยมีจำนวน 8 คอร์ และความเร็วสูงสุดถึง 4.8 GHz พร้อมหน่วยความจำหลักขนาด 16 GB โดยทั้งเมนบอร์ดและเฟิร์มแวร์ UEFI ก็ถูกระบุว่าเป็นฮาร์ดแวร์ LattePanda Mu Ultra อย่างถูกต้อง
สำหรับด้านกราฟิกนั้น ระบบก็ตรวจพบ GPU Intel Arc ในสถาปัตยกรรม Lunar Lake และทำงานผ่านไดรเวอร์เคอร์เนล xe ของ Linux ร่วมกับ Mesa 26.0.8 โดยรายงานว่ารองรับ OpenGL 4.6 และแสดงผลที่ความละเอียด 1920 × 1080 ความเร็ว 60 Hz นอกจากนั้นยังมีฮาร์ดแวร์อื่นที่ตรวจพบ ได้แก่ คอนโทรลเลอร์ Ethernet Intel I226-V ความเร็ว 2.5 Gbps ซึ่งเชื่อมต่อกับสวิตช์ของผมที่ความเร็ว 1 Gbps และคอนโทรลเลอร์ Intel HD Audio ส่วนหน่วยสำรองข้อมูลนั้นผมได้ติดตั้ง SSD WD Blue SN5000 NVMe ความจุ 500 GB ซึ่งให้พื้นที่ใช้งานจริงประมาณ 465.76 GiB
สรุปได้ว่าผลลัพธ์จาก inxi เบื้องต้นยืนยันว่า Ubuntu 26.04.1 LTS ตรวจจับองค์ประกอบฮาร์ดแวร์หลักของ LattePanda Mu Ultra ได้ครบ ทั้ง CPU, GPU แบบรวม, Ethernet, ระบบเสียง และ NVMe โดยอุณหภูมิ CPU ตอนไม่ได้ใช้งานอยู่ที่ราว 27.8°C ซึ่งเป็นการวัดตอน idle ไม่ใช่ผลจากการทดสอบโหลดหนัก
ผลทดสอบประสิทธิภาพ LattePanda Mu Ultra
sbc-bench
ต่อมาผมวัดประสิทธิภาพ LattePanda Mu Ultra ด้วย sbc-bench ของ Thomas Kaiser ซึ่งจะประเมินประสิทธิภาพของ CPU, แบนด์วิดท์ของหน่วยความจำ และพฤติกรรมทางความร้อนภายใต้โหลดต่อเนื่อง โดยรวมแล้วการทดสอบสามารถระบุสถาปัตยกรรมแบบไฮบริดของ Intel Core Ultra 7 256V ได้อย่างถูกต้อง ซึ่งประกอบด้วยคอร์ประสิทธิภาพสูง Lion Cove (P-core) 4 คอร์ และคอร์ประหยัดพลังงาน Skymont (E-core) 4 คอร์ โดยในสภาวะเริ่มต้น P-core วิ่งที่ประมาณ 4.69 GHz ส่วน E-core อยู่ที่ 3.69 GHz ใกล้เคียงกับความเร็วสูงสุดที่โฆษณาไว้
ข้อมูลระบบ:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 |
sbc-bench v0.9.72 LattePanda LattePanda Mu Ultra Standard / Ultra 7 256V (Tue, 20 Oct 2026 09:03:22 +0700) Distributor ID: Ubuntu Description: Ubuntu 26.04.1 LTS Release: 26.04 Codename: resolute Device Info: Manufacturer: LattePanda Product Name: LattePanda Mu Ultra Version: Standard SKU Number: LattePanda Mu Ultra Family: LattePanda Compute Module BIOS/UEFI: Vendor: LattePanda Version: SBCLNLCXR120-A Release Date: 04/30/2026 BIOS Revision: 5.32 /usr/bin/gcc (Ubuntu 15.2.0-16ubuntu1) 15.2.0 Uptime: 09:03:22 up 2 min, 1 user, load average: 0.33, 0.27, 0.10, 57.0°C, 29135556 Linux 7.0.0-38-generic (kumpee-LattePanda-Mu-Ultra) 10/20/26 _x86_64_ (8 CPU) avg-cpu: %user %nice %system %iowait %steal %idle 2.88 0.10 2.25 0.33 0.00 94.44 Device tps kB_read/s kB_wrtn/s kB_dscd/s kB_read kB_wrtn kB_dscd nvme0n1 268.28 8857.44 740.27 0.00 1160679 97005 0 total used free shared buff/cache available Mem: 14Gi 1.5Gi 13Gi 88Mi 469Mi 13Gi Swap: 4.0Gi 0B 4.0Gi Filename Type Size Used Priority /swap.img file 4194300 0 -1 ########################################################################## Intel P-States: Intel P-state driver initializing, HWP enabled Intel Hardware Feedback Interface enabled (2 core types) Powercap present. You might want to check with "powercap-info -p intel-rapl" Checking cpufreq OPP for cpu0-cpu3 (Lion Cove): Cpufreq OPP: 4700 Measured: 4685 (4685.871/4685.542/4685.542) Cpufreq OPP: 400 Measured: 395 (395.819/395.795/395.702) (-1.2%) Checking cpufreq OPP for cpu4-cpu7 (Skymont): Cpufreq OPP: 3700 Measured: 3687 (3687.656/3687.613/3687.571) Cpufreq OPP: 400 Measured: 398 (399.868/398.560/396.703) ########################################################################## Hardware sensors: coretemp-isa-0000 Package id 0: +50.0 C (high = +100.0 C, crit = +100.0 C) Core 0: +48.0 C (high = +100.0 C, crit = +100.0 C) Core 4: +45.0 C (high = +100.0 C, crit = +100.0 C) Core 8: +46.0 C (high = +100.0 C, crit = +100.0 C) Core 12: +46.0 C (high = +100.0 C, crit = +100.0 C) Core 32: +45.0 C (high = +100.0 C, crit = +100.0 C) Core 33: +45.0 C (high = +100.0 C, crit = +100.0 C) Core 34: +45.0 C (high = +100.0 C, crit = +100.0 C) Core 35: +45.0 C (high = +100.0 C, crit = +100.0 C) acpitz_0-acpi-0 temp1: +27.8 C nvme-pci-0100 Composite: +37.9 C (low = -40.1 C, high = +83.8 C) (crit = +87.8 C) Sensor 1: +57.9 C (low = -273.1 C, high = +65261.8 C) Sensor 2: +31.9 C (low = -273.1 C, high = +65261.8 C) /dev/nvme0: 38°C ... |
ผลทดสอบหน่วยความจำออกมาดี โดย P-core ทำได้ประมาณ 24.3 GB/s ในการทดสอบ memcpy เทียบกับ 15.3 GB/s ของ E-core ด้านประสิทธิภาพ CPU นั้น sbc-bench ใช้การบีบอัดและแตกไฟล์ด้วย 7-Zip ในการวัดทั้งแบบ single-thread และ multi-thread ในการทดสอบ single-thread P-core ทำคะแนนรวมได้ 4,670 MIPS ขณะที่ E-core ได้ 4,257 MIPS เมื่อรันทั้ง 8 คอร์พร้อมกัน การทดสอบ multi-thread ทำได้ 22,464, 19,894 และ 19,936 MIPS จากการรันติดกัน 3 ครั้ง เฉลี่ยประมาณ 20,760 MIPS
|
1 2 3 4 5 6 7 8 9 |
* cpu0 (Lion Cove): memcpy: 24269.5 MB/s, memchr: 29996.9 MB/s, memset: 95368.2 MB/s * cpu4 (Skymont): memcpy: 15307.0 MB/s, memchr: 24473.3 MB/s, memset: 23589.8 MB/s * cpu0 (Lion Cove) 16M latency: 31.68 26.24 32.37 26.49 31.51 28.43 29.62 40.94 * cpu4 (Skymont) 16M latency: 133.9 78.47 97.07 87.15 96.37 66.20 52.67 52.36 * cpu0 (Lion Cove) 128M latency: 131.1 124.0 130.3 122.9 130.8 119.5 102.0 91.82 * cpu4 (Skymont) 128M latency: 127.4 136.7 139.8 137.5 134.9 122.1 115.5 109.7 * 7-zip MIPS (3 consecutive runs): 22464, 19894, 19936 (20760 avg), single-threaded: 4670 * `aes-256-cbc 1068105.16k 1321878.95k 1420131.84k 1466167.30k 1483849.73k 1261436.93k (Lion Cove)` * `aes-256-cbc 1127751.79k 1282259.52k 1325331.03k 1336898.56k 1340235.78k 1338862.25k (Skymont)` |
สิ่งที่น่าสนใจที่สุดคือพฤติกรรมทางความร้อน ระหว่างการทดสอบหนัก อุณหภูมิของ CPU package พุ่งขึ้นถึง 95–96°C หลายครั้ง และระบบแสดงอาการ thermal throttling อย่างชัดเจน ภายใต้โหลดเต็มต่อเนื่อง ความถี่ของ P-core ลดจากประมาณ 4.7 GHz เหลือราว 2.1–2.2 GHz ซึ่งถือว่าลดลงมากเมื่อเทียบกับความถี่ในช่วง boost เริ่มต้น
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 |
... ########################################################################## Testing maximum cpufreq again, still under full load. System health now: Time big.LITTLE load %cpu %sys %usr %nice %io %irq Temp 09:16:41: 2100/1880MHz 8.03 100% 0% 99% 0% 0% 0% 96.0°C Checking cpufreq OPP for cpu0-cpu3 (Lion Cove): Cpufreq OPP: 2200 Measured: 2191 (2191.205/2191.156/2191.132) Checking cpufreq OPP for cpu4-cpu7 (Skymont): Cpufreq OPP: 3700 Measured: 3687 (3688.081/3687.826/3687.741) ########################################################################## ... System health while running 7-zip single core benchmark: Time big.LITTLE load %cpu %sys %usr %nice %io %irq Temp 09:08:12: 3728/3701MHz 1.04 11% 0% 10% 0% 0% 0% 95.0°C 09:08:17: 3637/3664MHz 1.03 12% 0% 12% 0% 0% 0% 96.0°C 09:08:22: 3659/3687MHz 1.03 12% 0% 12% 0% 0% 0% 96.0°C 09:08:27: 3669/3413MHz 1.03 12% 0% 12% 0% 0% 0% 96.0°C 09:08:32: 3596/3702MHz 1.02 12% 0% 12% 0% 0% 0% 96.0°C 09:08:37: 3652/3700MHz 1.02 12% 0% 12% 0% 0% 0% 95.0°C 09:08:42: 3528/3702MHz 1.02 12% 0% 12% 0% 0% 0% 96.0°C 09:08:47: 4515/3701MHz 1.02 12% 0% 12% 0% 0% 0% 87.0°C 09:08:52: 400/3701MHz 1.02 12% 0% 12% 0% 0% 0% 85.0°C 09:08:57: 400/3701MHz 1.02 12% 0% 12% 0% 0% 0% 81.0°C 09:09:02: 709/3701MHz 1.01 12% 0% 12% 0% 0% 0% 82.0°C 09:09:07: 820/3701MHz 1.01 12% 0% 12% 0% 0% 0% 80.0°C 09:09:12: 402/3701MHz 1.01 12% 0% 12% 0% 0% 0% 79.0°C System health while running 7-zip multi core benchmark: Time big.LITTLE load %cpu %sys %usr %nice %io %irq Temp 09:09:17: 3000/3401MHz 1.01 12% 0% 10% 0% 0% 0% 96.0°C 09:09:27: 1710/2400MHz 1.52 85% 0% 85% 0% 0% 0% 96.0°C 09:09:37: 2094/2672MHz 1.96 79% 0% 79% 0% 0% 0% 96.0°C 09:09:47: 455/3701MHz 2.89 90% 0% 89% 0% 0% 0% 96.0°C 09:09:59: 1911/2200MHz 3.60 83% 1% 82% 0% 0% 0% 96.0°C 09:10:11: 869/ 800MHz 4.20 84% 0% 84% 0% 0% 0% 95.0°C 09:10:23: 1986/2200MHz 5.11 92% 0% 92% 0% 0% 0% 96.0°C 09:10:35: 2147/1900MHz 5.04 76% 0% 75% 0% 0% 0% 96.0°C 09:10:47: 1888/2200MHz 5.58 74% 1% 73% 0% 0% 0% 96.0°C 09:10:59: 1865/2200MHz 6.19 82% 0% 82% 0% 0% 0% 96.0°C 09:11:11: 1895/2300MHz 5.91 79% 0% 79% 0% 0% 0% 96.0°C 09:11:23: 2060/2200MHz 6.13 77% 0% 77% 0% 0% 0% 96.0°C 09:11:34: 1352/2200MHz 5.86 73% 0% 73% 0% 0% 0% 96.0°C 09:11:44: 1900/1500MHz 6.19 96% 0% 95% 0% 0% 0% 95.0°C ... |
Geekbench 7
ผมยังได้ทดสอบวัดประสิทธิภาพ CPU และ GPU ของ LattePanda Mu Ultra ด้วย Geekbench 7.1.0 โดยเริ่มต้นผมใช้ออปชัน --gpu-list เพื่อทดสอบว่า Geekbench สามารถตรวจพบ GPU Intel Arc Graphics แบบรวมได้ทั้งผ่าน OpenCL และ Vulkan ได้ผลลัพธ์ตามข้อมูลด้านล่างนี้ครับ
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 |
kumpee@kumpee-LattePanda-Mu-Ultra:~/Downloads/Geekbench-7.1.0$ ./geekbench7 --gpu-list Geekbench 7.1.0 : https://www.geekbench.com/ ... OpenCL +-------------+-----------+---------------------------+ | Platform ID | Device ID | Description | +-------------+-----------+---------------------------+ | 0 | 0 | Intel(R) Arc(TM) Graphics | +-------------+-----------+---------------------------+ Vulkan +-------------+-----------+----------------------------------+ | Platform ID | Device ID | Description | +-------------+-----------+----------------------------------+ | 0 | 0 | Intel(R) Graphics (LNL) | +-------------+-----------+----------------------------------+ | 0 | 1 | llvmpipe (LLVM 21.1.8, 256 bits) | +-------------+-----------+----------------------------------+ |
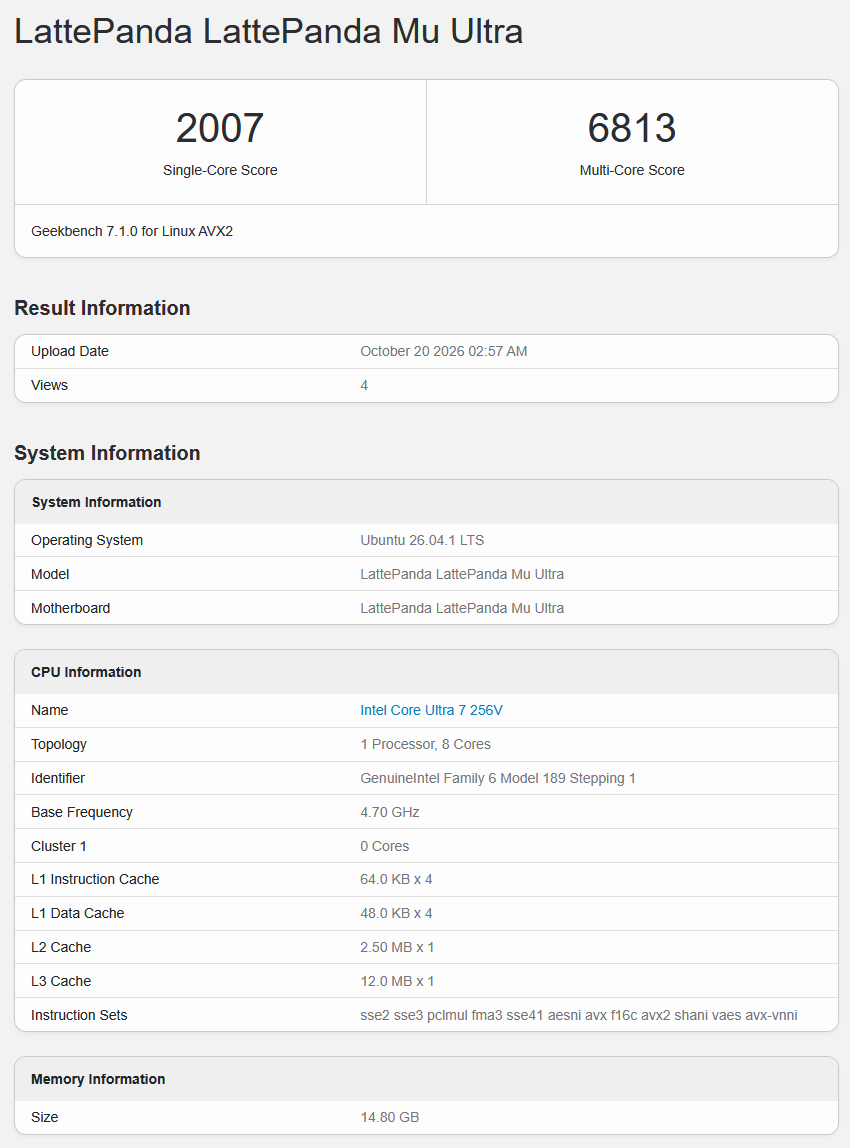
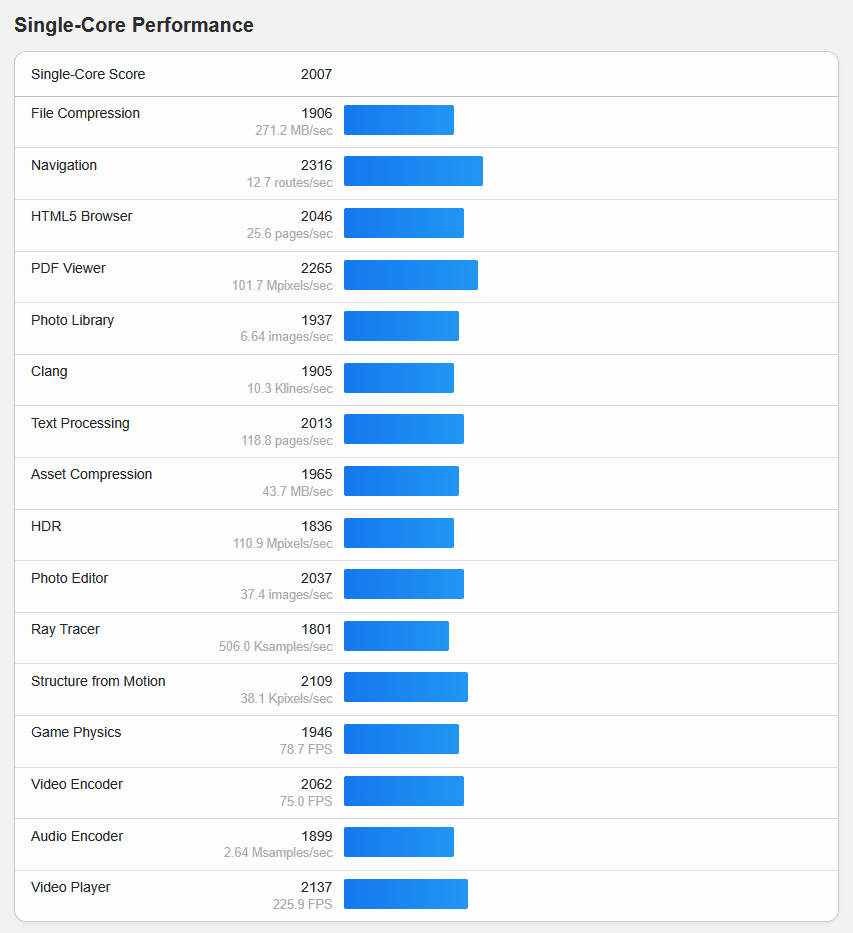
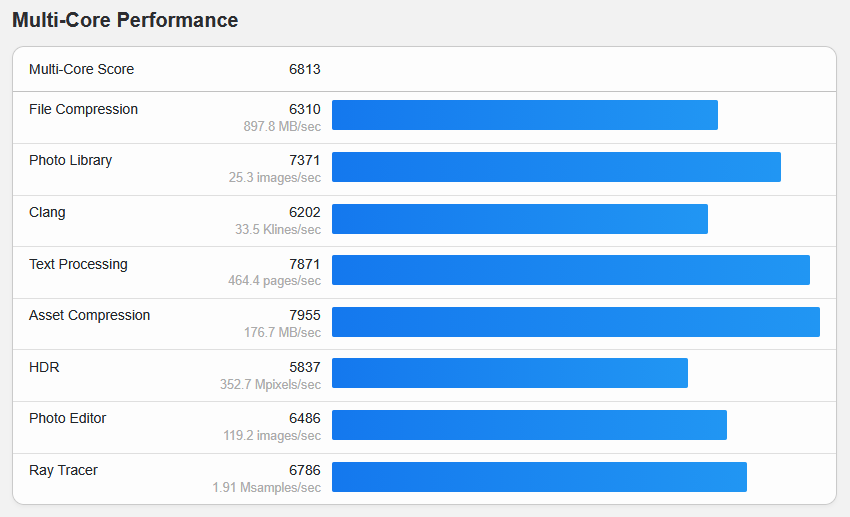
ด้านประสิทธิภาพ CPU LattePanda Mu Ultra ทำคะแนน single-core ได้ 2,007 คะแนน และ multi-core 6,813 คะแนน ในการทดสอบ single-core โปรเซสเซอร์ทำได้ 2,316 คะแนนในหมวด Navigation, 2,109 คะแนนในหมวด SfM และ 2,062 คะแนนในหมวด Video Encoding
สำหรับ multi-core คะแนนสูงสุดอยู่ในหมวด Asset Compression (7,955 คะแนน), Text Processing (7,871 คะแนน) และ Photo Library (7,371 คะแนน) ผลลัพธ์เหล่านี้สะท้อนความสามารถของโปรเซสเซอร์ทั้งในงานประมวลผลทั่วไปและงานแบบขนาน
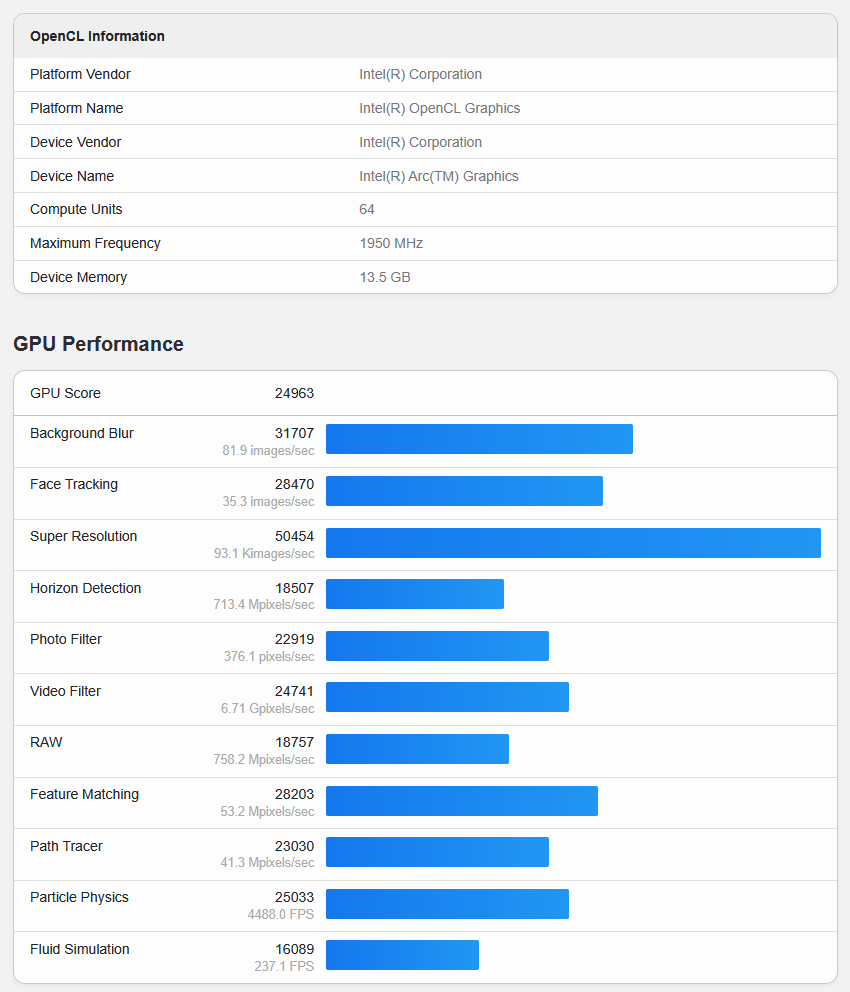
ด้านประสิทธิภาพ GPU พบว่า GPU Intel Arc Graphics แบบรวมทำคะแนน OpenCL ได้ 24,963 คะแนน โดยในการทดสอบย่อย Super Resolution ทำคะแนนสูงสุดที่ 50,454 คะแนน ตามมาด้วย Background Blur 31,707 คะแนน, Face Tracking 28,470 คะแนน และ Feature Matching 28,203 คะแนน ผลลัพธ์นี้ชี้ว่า GPU แบบรวมมีศักยภาพดีสำหรับงานประมวลผลภาพ คอมพิวเตอร์วิชัน และงานที่ใช้ GPU ช่วยเร่งความเร็ว
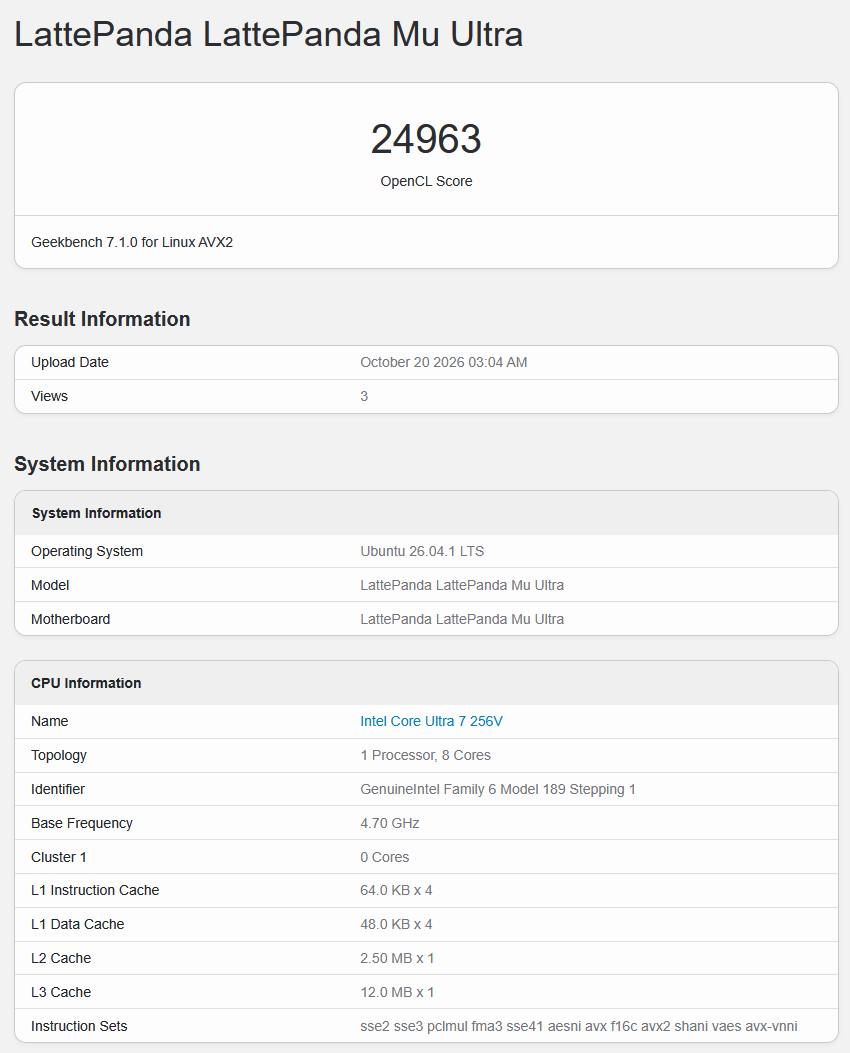
โดยรวมแล้ว Geekbench 7 ยืนยันว่า LattePanda Mu Ultra ให้ประสิทธิภาพ CPU และ GPU แบบรวมที่ทำได้ดีเมื่อเทียบกับขนาดที่เล็ก ทำให้เหมาะกับงานมัลติมีเดีย คอมพิวเตอร์วิชัน และ edge AI
วัดประสิทธิภาพ AI ด้วย Geekbench AI
หลังจากนั้นผมประเมินศักยภาพการประมวลผล AI ของ LattePanda Mu Ultra ด้วยGeekbench AI 1.7.0 โดยเครื่องมือนี้ตรวจพบเฟรมเวิร์กสำหรับการทำงานได้หลายตัว ทั้ง TensorFlow Lite, ONNX และ Intel OpenVINO ซึ่งสามารถใช้สำหรับการทดสอบบน CPU รวมถึง OpenVINO สำหรับ GPU Intel Arc แบบรวม
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 |
kumpee@kumpee-LattePanda-Mu-Ultra:~/Downloads/GeekbenchAI-1.7.0$ ./banff --ai-list Geekbench AI 1.7.0 : https://www.geekbench.com/ai/ Geekbench AI requires an active internet connection and automatically uploads benchmark results to the Geekbench Browser. +-----------------+----+---------+----+----------------------------------+----+ | Framework | ID | Backend | ID | Device | ID | +-----------------+----+---------+----+----------------------------------+----+ | TensorFlow Lite | 1 | CPU | 1 | Intel Core Ultra 7 256V | 0 | +-----------------+----+---------+----+----------------------------------+----+ | ONNX | 3 | CPU | 1 | Intel Core Ultra 7 256V | 0 | +-----------------+----+---------+----+----------------------------------+----+ | OpenVINO | 4 | CPU | 1 | Intel(R) Core(TM) Ultra 7 256V | 0 | +-----------------+----+---------+----+----------------------------------+----+ | OpenVINO | 4 | GPU | 2 | Intel(R) Arc(TM) Graphics (iGPU) | 1 | |
ด้วยแบ็กเอนด์ TensorFlow Lite บน CPU
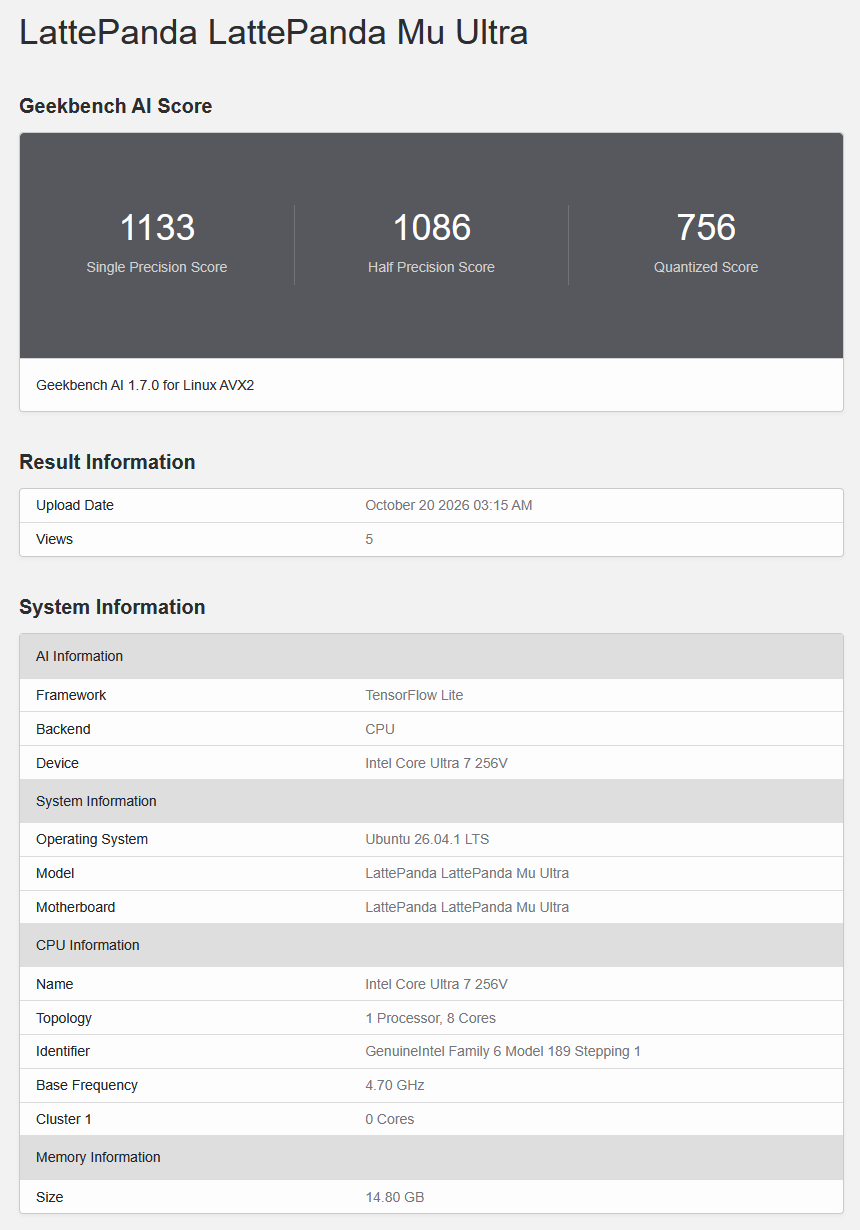
เมื่อใช้แบ็กเอนด์ TensorFlow Lite บน CPU LattePanda Mu Ultra พบว่าทำคะแนนได้ 1,133 ในแบบ single precision (SP), 1,086 ในแบบ half precision (HP) และ 756 ในการอินเฟอเรนซ์แบบควอนไทซ์ (Q) เมื่อดูการทดสอบย่อย image classification ทำได้ 189.9 IPS (SP), object detection 56.4 IPS (SP), image segmentation 17.1 IPS (SP) และ depth estimation 10.3 IPS (SP) ส่วนผลอื่น ๆ ได้แก่ face detection 15.6 IPS (HP), pose estimation 1.67 IPS (Q) และ image super-resolution 27.6 IPS (Q)
ด้วยแบ็กเอนด์ Intel OpenVINO บน CPU
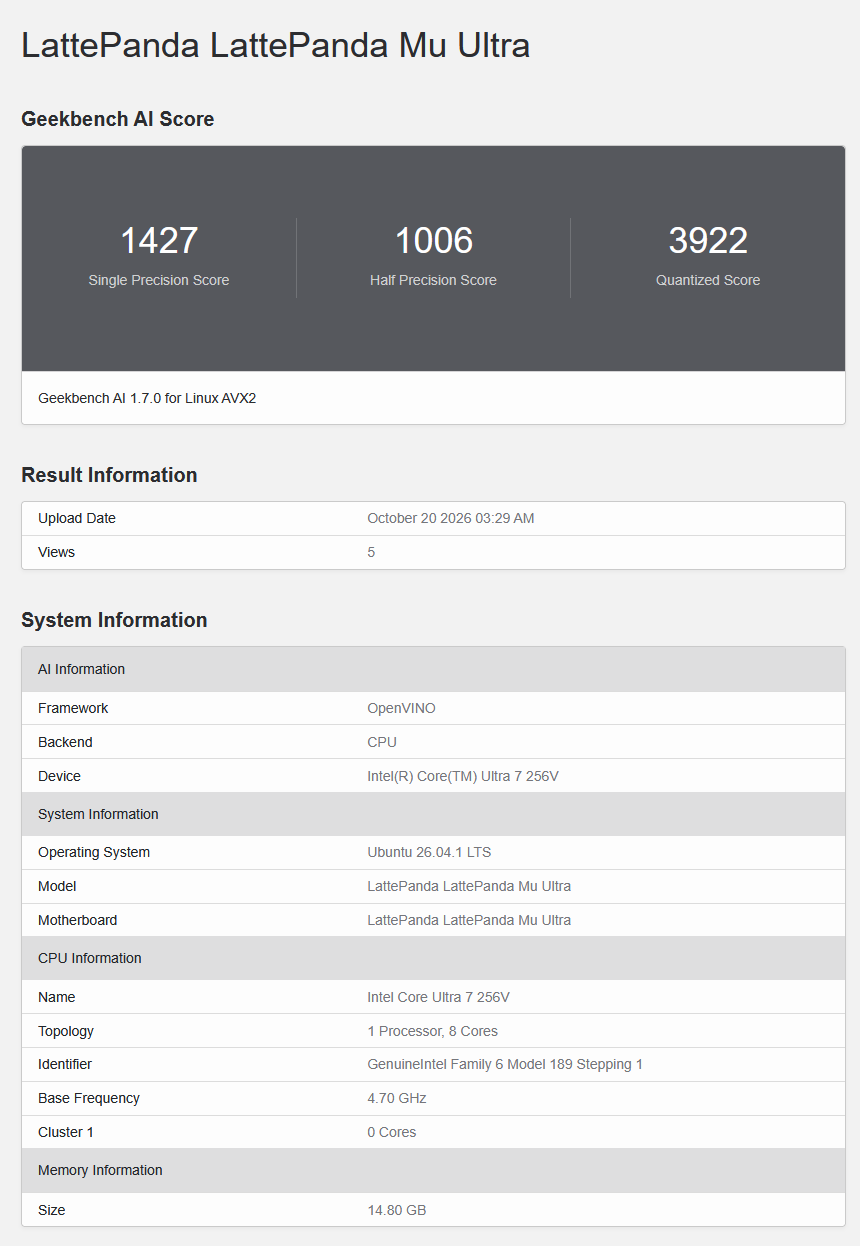
เมื่อใช้แบ็กเอนด์ Intel OpenVINO บน CPU โมดูลทำได้ 1,427 คะแนน (SP), 1,006 คะแนน (HP) และ 3,922 คะแนน (Q) ในการทดสอบย่อย image classification ทำได้ 184.9 IPS (SP), object detection 58.9 IPS (SP), image segmentation 17.6 IPS (SP) และ depth estimation 14.4 IPS (SP) ส่วนผลอื่น ๆ ได้แก่ face detection 22.4 IPS (HP), pose estimation 5.98 IPS (Q) และ image super-resolution 122.0 IPS (Q)
ด้วยแบ็กเอนด์ ONNX บน CPU
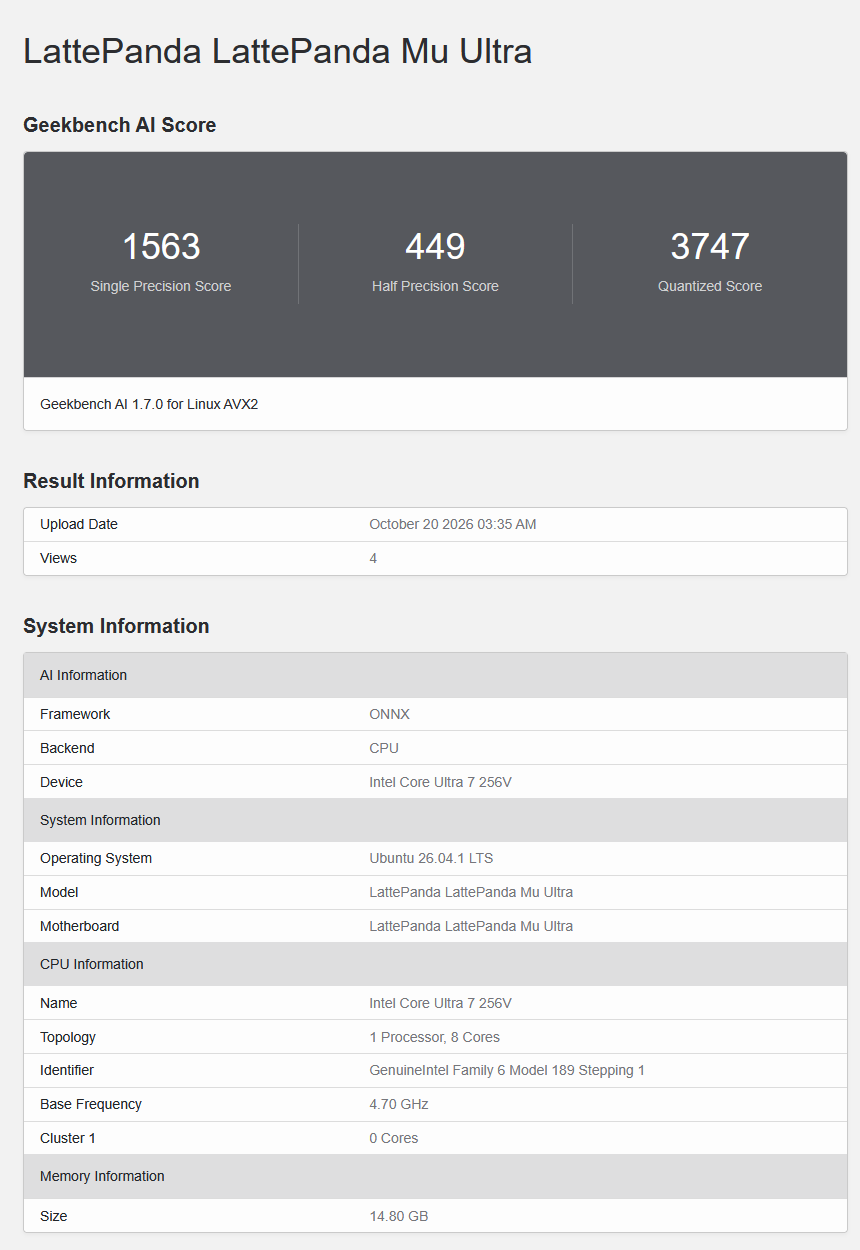
ด้วยแบ็กเอนด์ ONNX บน CPU LattePanda Mu Ultra ทำได้ 1,563 คะแนน (SP), 449 คะแนน (HP) และ 3,747 คะแนน (Q) ในการทดสอบย่อย image classification ทำได้ 219.0 IPS (SP), object detection 75.5 IPS (SP), image segmentation 13.2 IPS (SP) และ depth estimation 21.1 IPS (SP) ส่วนผลอื่น ๆ ได้แก่ face detection 78.7 IPS (Q), pose estimation 10.6 IPS (Q) และ image super-resolution 88.9 IPS (Q)
ด้วยแบ็กเอนด์ OpenVINO บน GPU: ล้มเหลว
ผมลองใช้ Geekbench AI 1.7.0 กับแบ็กเอนด์ OpenVINO บน GPU ด้วย แม้จะตรวจพบ GPU Intel Arc แบบรวมได้ แต่การทดสอบกลับล้มเหลวตั้งแต่การทดสอบ image classification ครั้งแรก ด้วยข้อผิดพลาด OpenCL CL_OUT_OF_RESOURCES อาจเป็นปัญหาความเข้ากันได้ระหว่าง Geekbench AI, OpenVINO และไดรเวอร์ GPU ที่ติดตั้งไว้ เนื่องจากแอปพลิเคชันอื่นที่ใช้ GPU ช่วยเร่งความเร็วทำงานได้เป็นปกติ
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 |
AI Information Framework OpenVINO Backend GPU Device Intel(R) Arc(TM) Graphics (iGPU) System Information Operating System Ubuntu 26.04.1 LTS Model LattePanda LattePanda Mu Ultra Motherboard LattePanda LattePanda Mu Ultra BIOS LattePanda SBCLNLCXR120-A CPU Information Name Intel Core Ultra 7 256V Topology 1 Processor, 8 Cores Identifier GenuineIntel Family 6 Model 189 Stepping 1 Base Frequency 4.70 GHz Memory Information Size 14.8 GB Running Image Classification (SP) Geekbench AI encountered an internal error. Contact support@primatelabs.com for help. Internal error message: Exception from src/inference/src/cpp/infer_request.cpp:224: Exception from src/plugins/intel_gpu/src/runtime/ocl/ocl_stream.cpp:376: [GPU] clFinish, error code: -5 CL_OUT_OF_RESOURCES |
อย่างไรก็ตาม ผมเลือกข้ามการทดสอบที่ล้มเหลวไปแล้ววัดอย่างอื่นต่อ เพราะในหัวข้อถัด ๆ ไปผมยังจะทดสอบ CPU, GPU และ NPU ด้วยเครื่องมืออย่าง llama.cpp และ YOLO26 อยู่แล้ว สรุปผล Geekbench AI ได้ว่า ONNX ทำได้ดีที่สุดในแบบ single precision ขณะที่ TensorFlow Lite เหนือกว่าเล็กน้อยในแบบ half precision ส่วน OpenVINO ทำได้ดีเป็นพิเศษกับโมเดลควอนไทซ์ โดยมี ONNX ตามมาไม่ไกล โดยรวม OpenVINO และ ONNX ให้ผลดีกว่าในการทดสอบส่วนใหญ่ สะท้อนให้เห็นว่าการเลือกแบ็กเอนด์สำหรับอินเฟอเรนซ์มีผลต่อประสิทธิภาพ AI มากเพียงใด แม้จะอยู่บนฮาร์ดแวร์เดียวกัน แม้ระบบจะตรวจพบ GPU แต่ก็มีการทดสอบอย่างน้อยหนึ่งรายการที่ล้มเหลวเมื่อใช้ OpenVINO และตรวจไม่พบ NPU เลย ซึ่งใกล้เคียงกับที่เราเจอตอนใช้ Geekbench AI ในรีวิวมินิพีซี GEEKOM IT13 Max (Intel Core Ultra 9 185G) กับ Ubuntu 26.04
การเล่นวิดีโอ YouTube
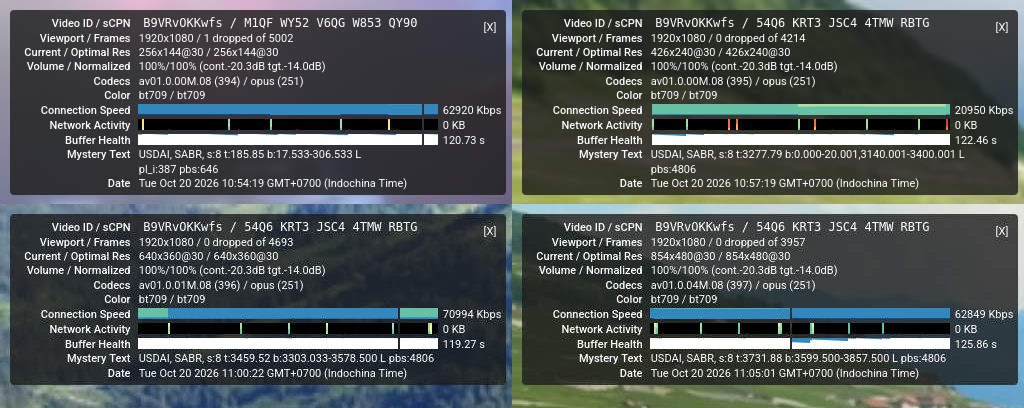
ต่อมาผมทดสอบการเล่นวิดีโอ YouTube ของ LattePanda Mu Ultra โดยเล่นวิดีโอที่ความละเอียดต่าง ๆ ตั้งแต่ 144p ไปจนถึง 2160p (4K) และใช้ฟีเจอร์ Stats for nerds ของ YouTube เพื่อดูประสิทธิภาพการเล่น รวมถึงจำนวนเฟรมที่หลุด โดยรวมการเล่นลื่นไหลในทุกความละเอียดที่ทดสอบ ภาพด้านล่างแสดงผลการเล่นที่ความละเอียด 144p ถึง 480p
ภาพถัดไปแสดงประสิทธิภาพการเล่นที่ความละเอียด 720p ถึง 2160p (4K) ซึ่งยังลื่นไหลในทุกความละเอียด
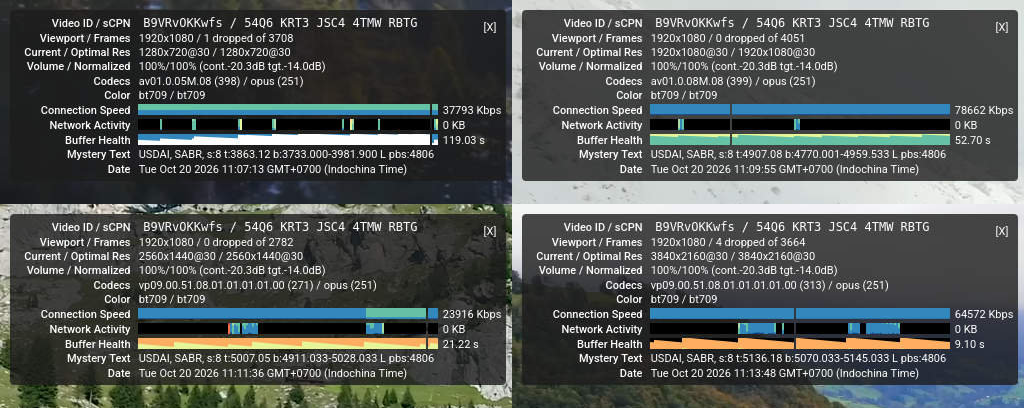
การทดสอบก่อนหน้านี้ทำบนจอที่ตั้งความละเอียด Full HD (1920 × 1080) จากนั้นผมเปลี่ยนความละเอียดหน้าจอเป็น 4K (3840 × 2160) แล้วทดสอบเล่น YouTube ซ้ำ ดังภาพด้านล่าง โดยรวมยังลื่นไหลที่ 4K มีเฟรมหลุดเพียงเล็กน้อย
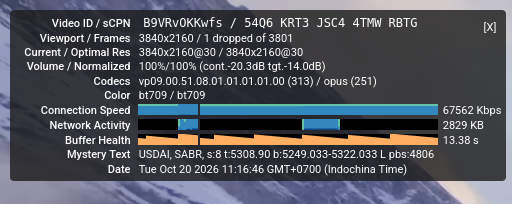
สรุปคือ LattePanda Mu Ultra รับมือการเล่น YouTube ความละเอียดสูงได้ดีมาก รวมถึงยังสามารถแสดงวิดีโอ 4K ที่เข้ารหัสด้วย codec สมัยใหม่ได้ดีด้วย
ประสิทธิภาพการท่องเว็บด้วย Speedometer 3.1
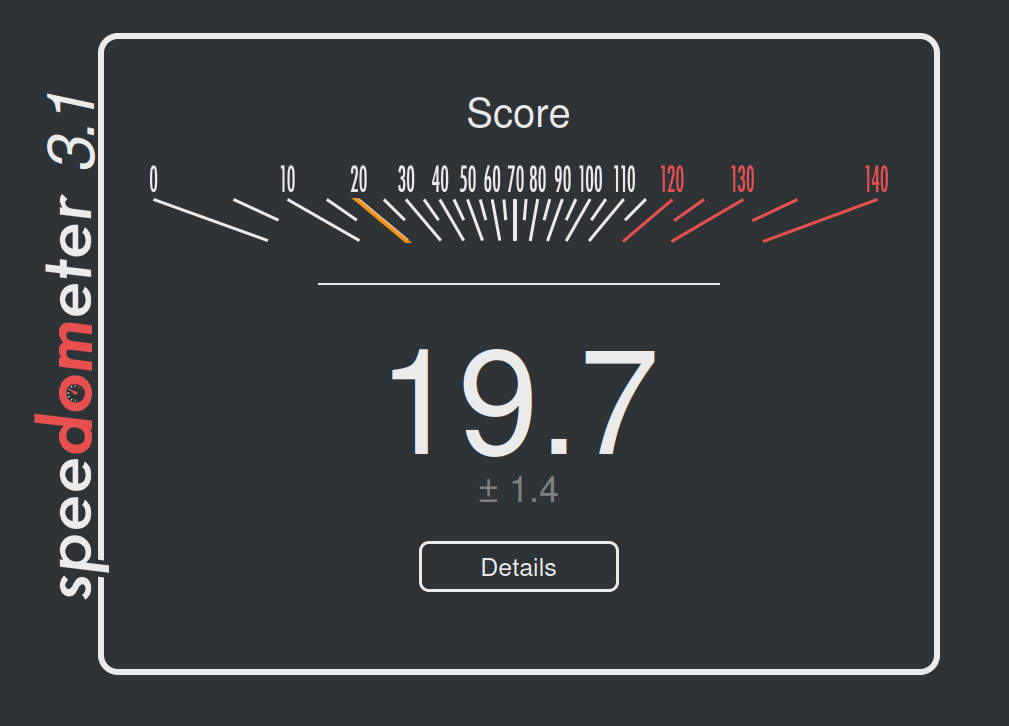
ผมทดสอบการท่องเว็บของ LattePanda Mu Ultra ด้วยSpeedometer 3.1 บน Google Chrome ที่ติดตั้งมากับระบบปฏิบัติ ผลการทดสอบมีคะแนนรวมเท่ากับ 19.7 ± 1.4 เมื่อดูการทดสอบย่อยพบว่ามอดูลทำแบบทดสอบ TodoMVC ที่ใช้ React ได้เฉลี่ย 49.4 ms, Vue 31.6 ms และ Svelte 22.6 ms สำหรับเว็บแอปที่ซับซ้อนขึ้น การทดสอบเว็บข่าวที่ใช้ Next.js ใช้เวลาราว 142.8 ms ขณะที่เวอร์ชัน Nuxt ใช้ 119.5 ms ผลอื่น ๆ ได้แก่ 30.7 ms สำหรับเอดิเตอร์ CodeMirror, 51.8 ms สำหรับ Chart.js และ 72.0 ms สำหรับการทดสอบแดชบอร์ดประสิทธิภาพ
วัดประสิทธิภาพ CPU, GPU และ NPU ด้วย llama.cpp
ลำดับถัดมา ผมตรวจความสามารถด้าน Vulkan ของระบบด้วยคำสั่ง vulkaninfo ผลยืนยันว่าตรวจพบ GPU แบบรวมของ Intel และรองรับ Vulkan 1.4 ผ่านไดรเวอร์ Mesa 26.0.8 แสดงว่า GPU พร้อมสำหรับการทดสอบกับ llama.cpp
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 |
... Device Properties and Extensions: ================================= GPU0: VkPhysicalDeviceProperties: --------------------------- apiVersion = 1.4.335 (4211023) driverVersion = 26.0.8 (109051912) vendorID = 0x8086 deviceID = 0x64a0 deviceType = PHYSICAL_DEVICE_TYPE_INTEGRATED_GPU deviceName = Intel(R) Graphics (LNL) ... VkPhysicalDeviceVulkan12Properties: ----------------------------------- driverID = DRIVER_ID_INTEL_OPEN_SOURCE_MESA driverName = Intel open-source Mesa driver driverInfo = Mesa 26.0.8-1ubuntu0.3 ... VkQueueFamilyProperties: ------------------------ queueFlags = QUEUE_GRAPHICS_BIT | QUEUE_COMPUTE_BIT | QUEUE_TRANSFER_BIT |
จากนั้นผมติดตั้งเครื่องมือพัฒนาและไลบรารีที่จำเป็น ทั้ง CMake, OpenBLAS และ Vulkan เพื่อเตรียมระบบสำหรับคอมไพล์และรัน llama.cpp หลังติดตั้งแพ็กเกจเหล่านี้แล้ว ผมโคลนโปรเจกต์ llama.cpp จาก GitHub อย่างเป็นทางการ สำหรับการวัดประสิทธิภาพ ผมเลือกโมเดลควอนไทซ์ 2 ตัว คือ Llama 3.2 3B Instruct (Q4_K_M) และ Llama 3.1 8B Instruct (Q4_K_M) ซึ่งมีขนาดไฟล์ประมาณ 1.87 GiB และ 4.58 GiB ตามลำดับ ผมเริ่มจากคอมไพล์ llama.cpp เวอร์ชัน CPU ซึ่งผ่านไปได้โดยไม่มีปัญหา
|
1 2 3 4 5 6 7 8 9 |
sudo apt install -y git cmake build-essential ninja-build libvulkan-dev vulkan-tools glslc libshaderc-dev Mesa-vulkan-drivers git clone https://github.com/ggml-org/llama.cpp.git cd llama.cpp cmake -B build-cpu \ -DGGML_VULKAN=OFF \ -DGGML_CUDA=OFF \ -DGGML_BLAS=OFF \ -DGGML_NATIVE=ON \ -DCMAKE_BUILD_TYPE=Release |
จากนั้นผมรันการวัดประสิทธิภาพด้วย 8 เธรด CPU ใช้อินพุต 512 โทเคน สร้างเอาต์พุต 128 โทเคน และทำซ้ำ 5 ครั้งต่อโมเดล โมเดล 3B ทำได้ 48.08 โทเคน/วินาทีในการประมวลผลพรอมต์ และ 13.59 โทเคน/วินาทีในการสร้างข้อความ
|
1 2 3 4 5 6 7 |
kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama-bench/llama.cpp$ ./build-cpu/bin/llama-bench -m ../models/Llama-3.2-3B-Instruct-Q4_K_M.gguf -ngl 0 -p 512 -t 8 -n 128 -r 5 | model | size | params | backend | threads | test | t/s | | ------------------------------ | ---------: | ---------: | ---------- | ------: | --------------: | -------------------: | | llama 3B Q4_K - Medium | 1.87 GiB | 3.21 B | CPU | 8 | pp512 | 48.08 ± 2.34 | | llama 3B Q4_K - Medium | 1.87 GiB | 3.21 B | CPU | 8 | tg128 | 13.59 ± 0.97 | build: 1d88cb05f (11749) |
ต่อมาผมคอมไพล์ llama.cpp ให้รองรับ Vulkan เพื่อใช้ GPU Intel Arc แบบรวม การคอมไพล์สำเร็จและ Vulkan ตรวจพบ GPU ได้ถูกต้อง โดย GPU ทำได้ 854.51 โทเคน/วินาทีในการประมวลผลพรอมต์ และ 14.14 โทเคน/วินาทีในการสร้างข้อความ เทียบกับ CPU แล้ว การประมวลผลพรอมต์เร็วขึ้นประมาณ 17.8 เท่า ขณะที่การสร้างข้อความดีขึ้นเพียงราว 4%
|
1 2 3 4 5 6 7 8 9 |
kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama-bench/llama.cpp$ ./build-vulkan/bin/llama-bench -m ../models/Llama-3.2-3B-Instruct-Q4_K_M.gguf -ngl 99 -p 512 -n 128 -r 5 ggml_vulkan: Found 1 Vulkan devices: ggml_vulkan: 0 = Intel(R) Graphics (LNL) (Intel open-source Mesa driver) | uma: 1 | fp16: 1 | bf16: 1 | fp4: 0 | warp size: 32 | shared memory: 49152 | int dot: 1 | matrix cores: KHR_coopmat | model | size | params | backend | ngl | test | t/s | | ------------------------------ | ---------: | ---------: | ---------- | --: | --------------: | -------------------: | | llama 3B Q4_K - Medium | 1.87 GiB | 3.21 B | Vulkan | 99 | pp512 | 854.51 ± 6.47 | | llama 3B Q4_K - Medium | 1.87 GiB | 3.21 B | Vulkan | 99 | tg128 | 14.14 ± 0.78 | build: 1d88cb05f (11749) |
จากนั้นผมรันการทดสอบบน CPU ซ้ำด้วยโมเดล Llama 3.1 8B Instruct ที่ใหญ่ขึ้น โดยใช้พารามิเตอร์เดิมเพื่อให้เปรียบเทียบได้ตรงกัน CPU ทำได้ 19.40 โทเคน/วินาทีในการประมวลผลพรอมต์ และ 6.16 โทเคน/วินาทีในการสร้างข้อความ ตามคาดว่าประสิทธิภาพจะลดลงเมื่อโมเดลใหญ่ขึ้น โดยเฉพาะในช่วงการสร้างโทเคนแบบต่อเนื่อง
|
1 2 3 4 5 6 7 |
kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama-bench/llama.cpp$ ./build-cpu/bin/llama-bench -m ../models/Meta-Llama-3.1-8B-Instruct-Q4_K_M.gguf -ngl 0 -t 8 -p 512 -n 128 -r 5 | model | size | params | backend | threads | test | t/s | | ------------------------------ | ---------: | ---------: | ---------- | ------: | --------------: | -------------------: | | llama 8B Q4_K - Medium | 4.58 GiB | 8.03 B | CPU | 8 | pp512 | 19.40 ± 0.42 | | llama 8B Q4_K - Medium | 4.58 GiB | 8.03 B | CPU | 8 | tg128 | 6.16 ± 0.30 | build: 1d88cb05f (11749) |
สุดท้ายผมทดสอบโมเดล 8B ด้วย Vulkan โดยเปิดให้ออฟโหลดงานไปยัง GPU GPU ทำได้ 303.38 โทเคน/วินาทีในการประมวลผลพรอมต์ และ 6.44 โทเคน/วินาทีในการสร้างข้อความ คิดเป็นการประมวลผลพรอมต์เร็วขึ้นประมาณ 15.6 เท่าเมื่อเทียบกับ CPU ส่วนการสร้างข้อความดีขึ้นเพียงราว 4.5%
|
1 2 3 4 5 6 7 8 9 |
kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama-bench/llama.cpp$ ./build-vulkan/bin/llama-bench -m ../models/Meta-Llama-3.1-8B-Instruct-Q4_K_M.gguf -ngl 99 -p 512 -n 128 -r 5 ggml_vulkan: Found 1 Vulkan devices: ggml_vulkan: 0 = Intel(R) Graphics (LNL) (Intel open-source Mesa driver) | uma: 1 | fp16: 1 | bf16: 1 | fp4: 0 | warp size: 32 | shared memory: 49152 | int dot: 1 | matrix cores: KHR_coopmat | model | size | params | backend | ngl | test | t/s | | ------------------------------ | ---------: | ---------: | ---------- | --: | --------------: | -------------------: | | llama 8B Q4_K - Medium | 4.58 GiB | 8.03 B | Vulkan | 99 | pp512 | 303.38 ± 4.57 | | llama 8B Q4_K - Medium | 4.58 GiB | 8.03 B | Vulkan | 99 | tg128 | 6.44 ± 0.35 | build: 1d88cb05f (11749) |
กราฟด้านล่างเปรียบเทียบประสิทธิภาพการอินเฟอเรนซ์ระหว่าง CPU และ GPU ของทั้งสองโมเดล Llama
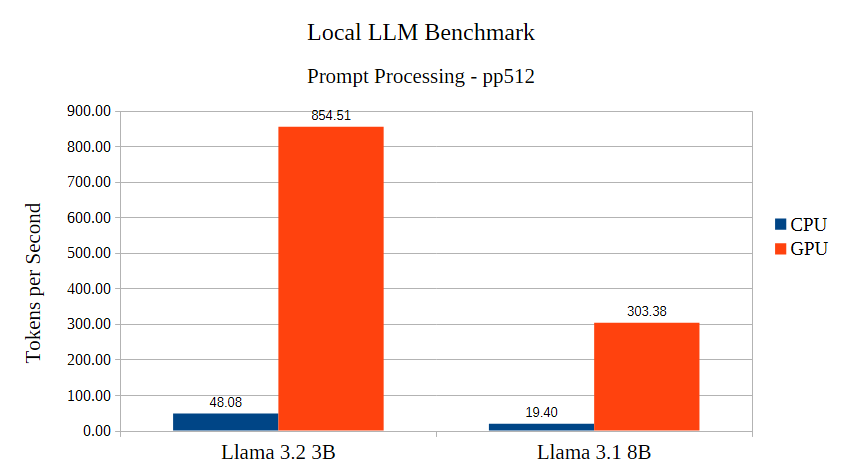
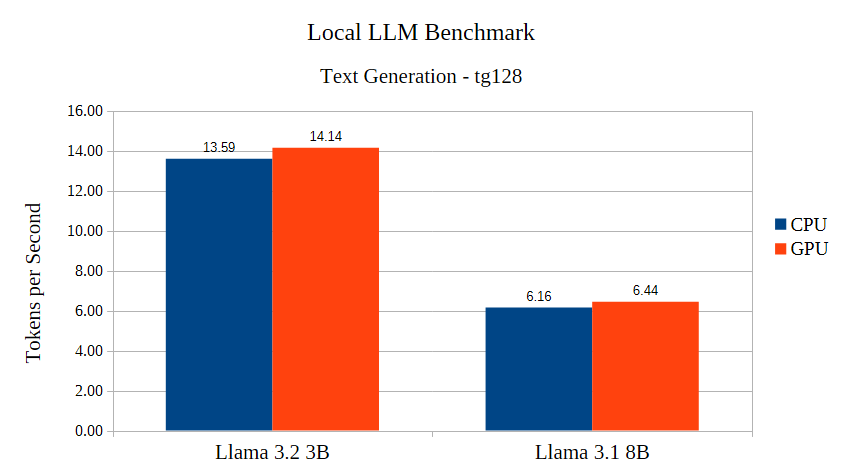
ผลลัพธ์ชัดเจนว่า GPU ช่วยเร่งความเร็วได้อย่างมากในขั้นตอนประมวลผลพรอมต์ โดยเฉพาะเมื่อต้องรับมือกับอินพุตที่ยาวขึ้น แต่การสร้างข้อความกลับได้ความเร็วใกล้เคียงกันระหว่าง CPU และ GPU ภายใต้เงื่อนไขการทดสอบนี้ ชี้ว่า GPU มีประโยชน์สูงสุดในขั้นประมวลผลพรอมต์มากกว่าขั้นสร้างโทเคนแบบต่อเนื่อง
ผมเองก็ลองตั้งค่า llama.cpp เพื่อทดสอบการใช้ NPU Intel AI Boost อยู่เหมือนกัน แต่การตั้งค่าค่อนข้างซับซ้อนและต้องติดตั้ง dependency เพิ่มหลายตัว และเพื่อไม่ให้ระบบที่ใช้งานอยู่ถูกเปลี่ยนแปลงโดยไม่จำเป็น ผมจึงเปลี่ยนไปใช้ Intel OpenVINO แทน โดยผมสร้าง virtual environment ของ Python ขึ้นใหม่ ติดตั้งแพ็กเกจที่ต้องใช้ และตรวจพบอุปกรณ์ครบทั้งสาม คือ CPU, GPU และ NPU ตามคำสั่งด้านล่างนี้
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 |
python3 -m venv ~/openvino-env source ~/openvino-env/bin/activate pip install --upgrade pip pip install openvino sudo apt install -y \ build-essential \ cmake \ ninja-build \ libcurl4-openssl-dev \ libtbb12 \ ocl-icd-opencl-dev \ opencl-headers \ opencl-clhpp-headers \ Intel-opencl-icd python -m pip install \ "optimum-intel[openvino]" \ nncf \ transformers |
หลังติดตั้งเสร็จ ผมใช้สคริปต์ Python ง่าย ๆ ที่สร้างโดย ChatGPT เพื่อตรวจว่า OpenVINO มองเห็นอุปกรณ์ประมวลผลที่มีอยู่หรือไม่ สคริปต์ทำงานได้และยืนยันว่าเข้าถึง CPU, GPU และ NPU ได้ทั้งหมดจากสภาพแวดล้อมเสมือนของ Python
|
1 2 3 4 5 |
(openvino-env) kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents$ python llama_openvino/test_openvino.py Available OpenVINO devices: CPU: Intel(R) Core(TM) Ultra 7 256V GPU: Intel(R) Arc(TM) Graphics (iGPU) NPU: Intel(R) AI Boost |
จากนั้นผมให้ ChatGPT เขียนสคริปต์ Python อีกตัวเพื่อทดสอบประสิทธิภาพการใช้งาน LLM ด้วย OpenVINO GenAI โดยโมเดลเล็กอย่าง TinyLlama ทำได้ราว 22–30 โทเคน/วินาที โดยใช้เวลาถึงโทเคนแรก (TTFT) 0.5–0.7 วินาที
|
1 2 3 4 |
(openvino-env) kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama_openvino$ python test_rum_llm_openvino.py TTFT: 523.9 ms TPOT: 44.7 ms/token Throughput: 22.4 tokens/s |
ส่วนโมเดลที่ใหญ่กว่าอย่าง Qwen2.5 7B ช้ากว่าอย่างเห็นได้ชัด ทำได้ราว 5–8 โทเคน/วินาที และมี TTFT ประมาณ 4–7.6 วินาที
|
1 2 3 4 |
(openvino-env) kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama_openvino$ python test_rum_llm_openvino.py TTFT: 4590.5 ms TPOT: 155.7 ms/token Throughput: 6.4 tokens/s |
สรุปได้ว่าการทดสอบยืนยันว่า LattePanda Mu Ultra รัน LLM ภายในเครื่องได้ทั้งบน CPU, GPU แบบรวม และ NPU โดย GPU ช่วยเร่งการประมวลผลพรอมต์ได้มาก ส่วน NPU ก็รับงานอินเฟอเรนซ์ LLM ผ่าน OpenVINO ได้สำเร็จ
YOLO26 บนชุดพัฒนา LattePanda Mu Ultra
ประสิทธิภาพการอินเฟอเรนซ์ YOLO26 แบบ forward-only
ผมสร้าง virtual environment ของ Python แยกต่างหากสำหรับทดสอบโมเดล YOLO26 กับ OpenVINO โดยติดตั้งคลังโปรแกรมที่จำเป็นดังนี้
|
1 2 3 4 |
python3 -m venv venv_yolo26 source venv_yolo26/bin/activate python -m pip install --upgrade pip python -m pip install opencv-python "openvino==2026.2.0" "ultralytics[export-openvino]" numpy |
จากนั้นผมให้ ChatGPT เขียนสคริปต์ Python อีกตัวเพื่อวัดประสิทธิภาพการอินเฟอเรนซ์ YOLO26 ด้วย OpenVINO โดยผมเลือกทดสอบ 3 โมเดล ประกอบด้วย YOLO26n, YOLO26s และ YOLO26m และทำการทดสอบโมเดลแต่ละตัวบน CPU, GPU และ NPU โดยแต่ละโมเดลถูก export เป็นรูปแบบ FP16 ด้วยความละเอียดอินพุตคงที่ 640 × 640 พิกเซล โค้ดด้านล่างเป็นฟังก์ชันหลักที่ใช้วัดเวลาในการอินเฟอเรนซ์และคำนวณ FPS เทียบเท่า
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 |
# Warm up the device before timing for _ in range(warmup): request.infer() # Measure inference latency times_ms = np.empty(iterations, dtype=np.float64) for i in range(iterations): start = time.perf_counter_ns() request.infer() times_ms[i] = (time.perf_counter_ns() - start) * 1e-6 # Calculate average latency and equivalent FPS mean_ms = float(times_ms.mean()) equiv_fps = 1000.0 / mean_ms |
การทดสอบประกอบด้วยการวอร์มอุปกรณ์ 50 รอบและการวัดเวลาจริง 500 รอบ โดยใช้อินพุตสังเคราะห์ เพื่อวัดเวลาในการอินเฟอเรนซ์และ FPS เทียบเท่า โดยไม่รวมเวลาในการประมวลผลภาพจากกล้องและการโพสต์โปรเซส กราฟด้านล่างเปรียบเทียบผลลัพธ์ของอุปกรณ์ทั้งสามกับโมเดลทั้งสาม

ผลออกมาน่าประทับใจ GPU Intel Arc ครับ โดยมอดูลทำได้ 411, 210 และ 116 FPS สำหรับทั้งสามโมเดล ขณะที่ NPU ทำได้ 357, 189 และ 68 FPS ตามลำดับ ส่วนการประมวลผลบน CPU ช้ากว่าอย่างชัดเจน ทำได้ 19.2, 5.8 และ 2.1 FPS และที่น่าสนใจคือ NPU ทำได้เกินตัวเลขที่ผู้ผลิตโฆษณาไว้สำหรับ YOLO26n และ YOLO26s คือสูงถึง 152% และ 119% ตามลำดับ ผลลัพธ์นี้ชี้ว่าอุปกรณ์มีความสามารถในการเร่งความเร็ว AI ที่แข็งแกร่ง แม้ตัวเลข FPS ที่รายงานจะเป็นประสิทธิภาพเฉพาะการอินเฟอเรนซ์เท่านั้น
การตรวจจับและติดตาม YOLO26 แบบเรียลไทม์ด้วยเว็บแคม
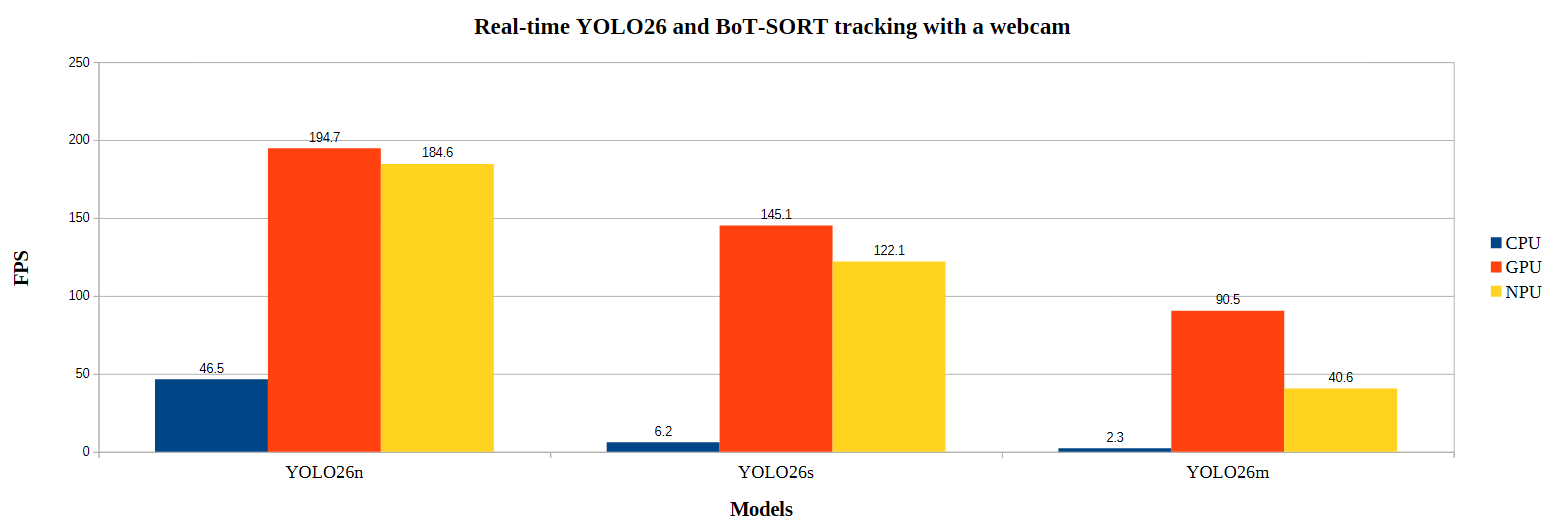
ต่อมาผมทดสอบการตรวจจับวัตถุ YOLO26 แบบเวลาจริง โดยเพิ่มการติดตามด้วย BoT-SORT โดยใช้กล้อง USB และ OpenVINO บน CPU, GPU และ NPU ผลทดสอบแบบ forward-only เหมือนการทดสอบก่อนหน้านี้ซึ่งไม่รวมการประมวลผลภาพจากกล้องและงานติดตาม ทำได้ต่ำกว่าการทดสอบก่อนหน้าเล็กน้อย ตัวอย่างเช่น YOLO26n ทำได้ 18.7, 362.5 และ 321.6 FPS บน CPU, GPU และ NPU ตามลำดับ เทียบกับ 19.2, 411.1 และ 357.0 FPS ในการทดสอบครั้งก่อน

ภาพด้านล่างแสดงประสิทธิภาพจากการทดสอบเว็บแคมแบบเรียลไทม์เต็มรูปแบบ ซึ่งรวมการตรวจจับวัตถุ YOLO26, การติดตามด้วย BoT-SORT และการวาด UI บน CPU นั้น YOLO26n ทำได้ประมาณ 48.5 FPS ขณะที่ YOLO26s และ YOLO26m ลดลงเหลือ 6.2 และ 2.3 FPS ตามลำดับ เมื่อเปลี่ยนไปใช้ GPU หรือ NPU ประสิทธิภาพดีขึ้นอย่างมาก เช่น YOLO26s เพิ่มจาก 6.2 FPS บน CPU เป็น 145.1 FPS บน GPU
ทดสอบการประมาณค่าความลึกด้วย Depth Anything V2
ต่อมาผมทดสอบการประมาณค่าความลึกจากวิดีโอแบบเรียลไทม์ด้วย Depth Anything V2 ในสภาพแวดล้อม Python ที่สร้างใหม่เพื่อไม่ให้รบกวนการทดลองอื่น จากนั้นให้ ChatGPT เขียนสคริปต์ Python ง่าย ๆ ที่ใช้กล้อง USB เป็นอินพุตวิดีโอสด พร้อม NumPy และ OpenCV สำหรับประมวลผลและแสดงภาพ สำหรับการทดสอบเร็ว ๆ นี้ผมใช้โมเดล V2-Base ซึ่งมีขนาดประมาณ 97.5 MB สคริปต์ทำงานได้ลื่นไหล ทำได้ 25–30 FPS เมื่อเปิดใช้การเร่งความเร็วด้วย GPU
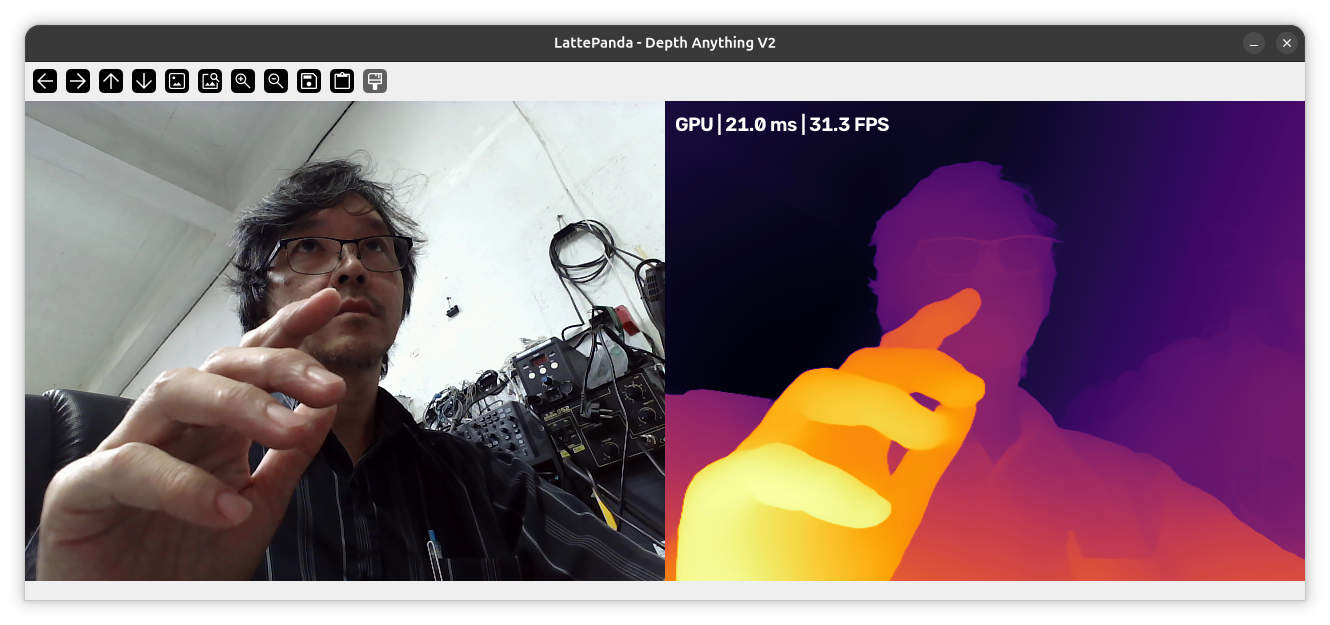
วิดีโอด้านล่างนี้เป็นวิดีโอสั้น ๆ ที่แสดงผลการทำงานในสภาพแวดล้อมนอกห้องทำงานครับ
เดโม: ปรับแต่งวิดีโอจากเว็บแคมแบบเรียลไทม์ด้วยท่าทางมือ
สำหรับเดโมชิ้นสุดท้ายของการรีวิวนี้ ผมได้เตรียมโปรแกรมใหม่โดยรวมการตรวจจับวัตถุด้วย YOLO26 เข้ากับการติดตามท่าทางมือของ MediaPipe และการตรวจจับจุดสำคัญบนใบหน้าและร่างกาย แอปพลิเคชันนี้ยังรองรับการปรับแต่งภาพจากเว็บแคมแบบเรียลไทม์ด้วยท่าทางมือ โดยติดตามมือทั้งสองข้างพร้อมกัน มือซ้ายควบคุม hue และ saturation ส่วนมือขวาปรับ contrast และ brightness ผู้ใช้เพียงใช้นิ้วโป้งกับนิ้วชี้จับคู่กันเพื่อเปิดการควบคุม ขยับมือเพื่อปรับภาพ แล้วปล่อยนิ้วเพื่อล็อกค่าที่ตั้งไว้ตามตัวอย่างในภาพด้านล่างนี้ครับ
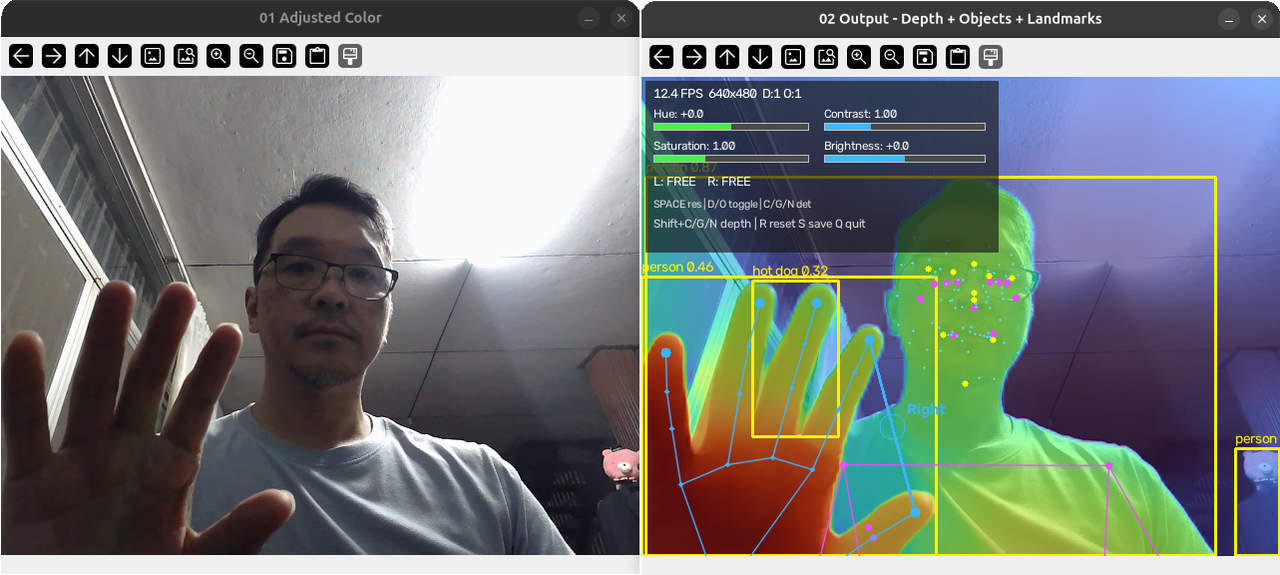
วิดีโอด้านล่างนี้เป็นวิดีโอสั้นที่ผมแสดงการทำงานแบบเวลาจริง โดยรวม ๆ แล้วก็พบว่าทำงานได้ดีที่ความละเอียดเริ่มต้น 640 × 480 ซึ่งทำอัตราการแสดงผลได้ราว 28–30 FPS แต่ว่าประสิทธิภาพนี้จะลดลงเหลือประมาณ 10 FPS เมื่อเปลี่ยนขนาดของภาพอินพุตเป็น 1280 × 720 และลดลงเหลือ 5 FPS เมื่อทดสอบกับวิดีโอขนาด 1920 × 1080 โดยเหตุผลสำคัญอาจจะเนื่องจากภาระการประมวลผลที่เพิ่มขึ้นตามขนาดภาพอินพุตครับ
หากสนใจ ก็สามารถดูโค้ด Python นี้ (ที่สร้างโดย AI) ได้บน GitHub ครับ
บทสรุป
โดยรวมผมพอใจกับประสิทธิภาพของ LattePanda Mu Ultra มากครับ การประกอบฮาร์ดแวร์ทำได้ง่าย ตรงไปตรงมา และการติดตั้งระบบปฏิบัติการกับไดรเวอร์ในเบื้องต้นก็ไม่ยาก แม้ว่าคำแนะนำการติดตั้งบางส่วนจะสับสนอยู่บ้าง แต่ปัญหาส่วนใหญ่ที่ผมเจอมาจากซอฟต์แวร์ภายนอกและความเข้ากันได้กับ Linux มากกว่าตัวโมดูลเอง สำหรับการทดสอบการทำงานบน CPU, GPU และ NPU นั้นก็สามารถทำงานได้ดีในการทดสอบทั้งหมด ทำให้ LattePanda Mu Ultra เป็นตัวเลือกที่น่าสนใจสำหรับงาน AI บนอุปกรณ์ขนาดเล็ก และในฐานะนักวิจัยผมมองว่ามอดูลขนาดกะทัดรัดนี้ดึงดูดใจเป็นพิเศษ โดยเฉพาะตอนนี้ที่ผมกำลังมองหาคอมพิวเตอร์ขนาดเล็กที่สามารถรัน LLM ภายในเครื่องและรองรับการทำงานด้าน AI อื่น ๆ ได้
สุดท้ายนี้ผมขอขอบคุณ DFRobot ที่ส่งสินค้ามาให้รีวิว โดยชุดพัฒนา LattePanda Mu Ultra 256V AI ที่รีวิวในครั้งนี้มีจำหน่ายในราคา $733 (~24,500฿) ที่ DFRobot ซึ่งรวมโมดูล, mini carrier board และ active cooler ส่วนตัวโมดูลอย่างเดียวมีราคา $699.00 (~23,400฿) เมื่อใช้ CPU Core Ultra 7 256V หรือ $599 (~20,000฿) เมื่อใช้ Core Ultra 5 225V
แปลจากบทความ : LattePanda Mu Ultra Review – An Intel Core Ultra 7 256V AI Compute Module tested on Ubuntu 26.04

I am an assistant professor in surveying engineering and geographic information systems at Rambhai Barni Rajabhat University. My primary research areas include digital image/audio processing, digital photogrammetry, AI, IoT, and UAV. I am open to other subjects as well.